第 04 课
分支、循环与常用数据结构
从一条耗时记录的判断开始,依次学习分支、列表遍历、循环计数和字典取值,再将它们连成一个日志分类统计程序。用独立短例认识其他循环写法、元组与集合。
让日志程序自动分类并统计
上一课已经能记录一次事件。本课让程序根据条件选择动作,再逐条处理一组日志,统计每种情况的数量。
看清知识之间的关系
沿着学习路线,把知识点连成完整任务。点击知识点,可以跳到对应内容。
条件与分支
让程序根据条件选择一条路径
循环与计数
逐项处理数据,保留每轮的结果
常用数据结构
按数据的用途选择保存方式
日志分类统计
把分支、循环和数据结构连起来
开始前准备好
- 基础
- 会赋值、比较、print 和 f-string。
- 工具
- 沿用 Python 3.10.11 与 VS Code,无需安装额外库。
- 文件
- 在 VS Code 打开“第4课”文件夹,创建 practice.py。每个短例完整替换它;综合操作时再下载 log_summary.py。
理解代码,动手运行
用条件选择一个动作
先把上一课的 True/False 变成两种不同的输出。为什么需要 if
duration_ms >= 1000 只会得到 True 或 False。if 根据这个结果决定要不要执行一组语句:条件为 True 时执行 if 下方的内容;否则执行 else 下方的内容。这种按条件选择路径的写法叫作分支。
if 后写条件,再写英文冒号;下一行缩进四个空格,表示它属于这个分支。else 与 if 左侧对齐,不再写条件。缩进相同的连续语句组成一个代码块。
duration_ms = 1000
SLOW_LIMIT_MS = 1000

if duration_ms >= SLOW_LIMIT_MS:
    print("耗时偏长")
else:
    print("耗时正常")

print("本条判断结束")
将下面的完整短例写入 practice.py。SLOW_LIMIT_MS 保存课堂使用的 1000 毫秒阈值。
程序按什么顺序执行
先保存耗时和阈值,再计算比较结果。满足条件就输出“耗时偏长”,否则输出“耗时正常”。选中的代码块执行完后,程序接着执行分支之后未缩进的语句;不会再回头执行另一边。
沿 1000 毫秒对应的分支,找到最后一条输出。
手机上可左右滑动;点击图片可以查看完整图保存并运行第一次判断
- 01
保持缩进,再运行
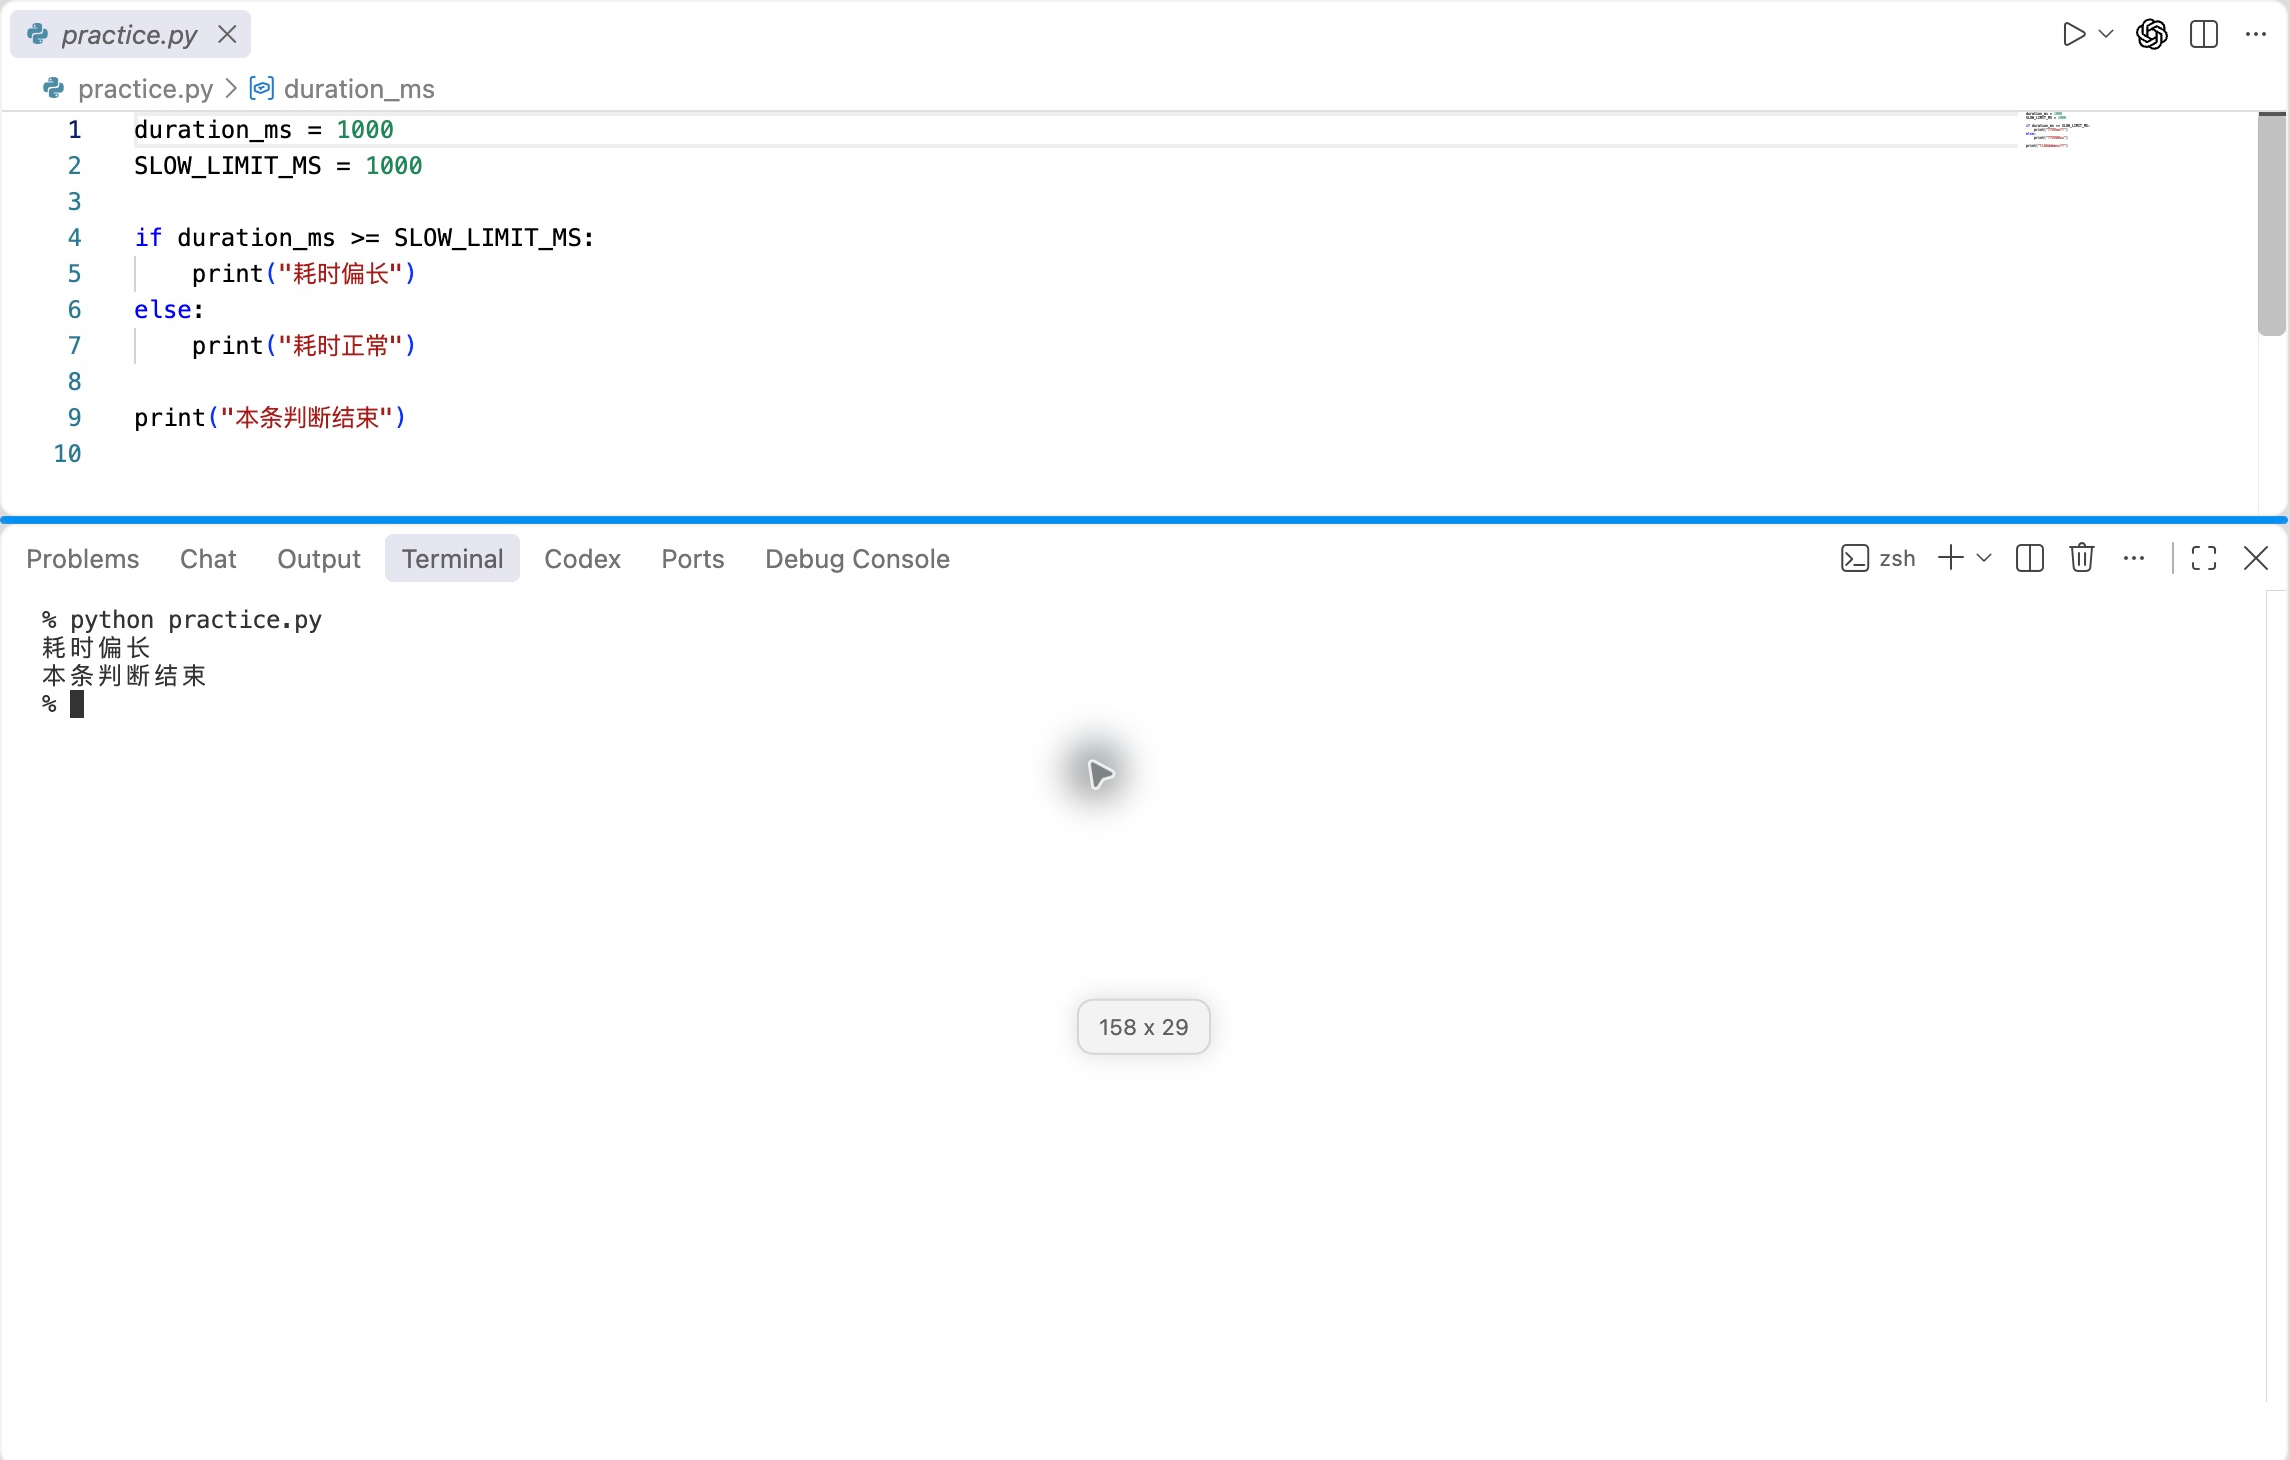
这样做保存 practice.py(Windows 按 Ctrl+S,Mac 按 Command+S;截图使用 Mac)。选择“终端 → 新建终端”,在当前文件夹运行 python practice.py。沿用 python3 命令的同学输入 python3 practice.py。命令写在终端,代码写在编辑器。
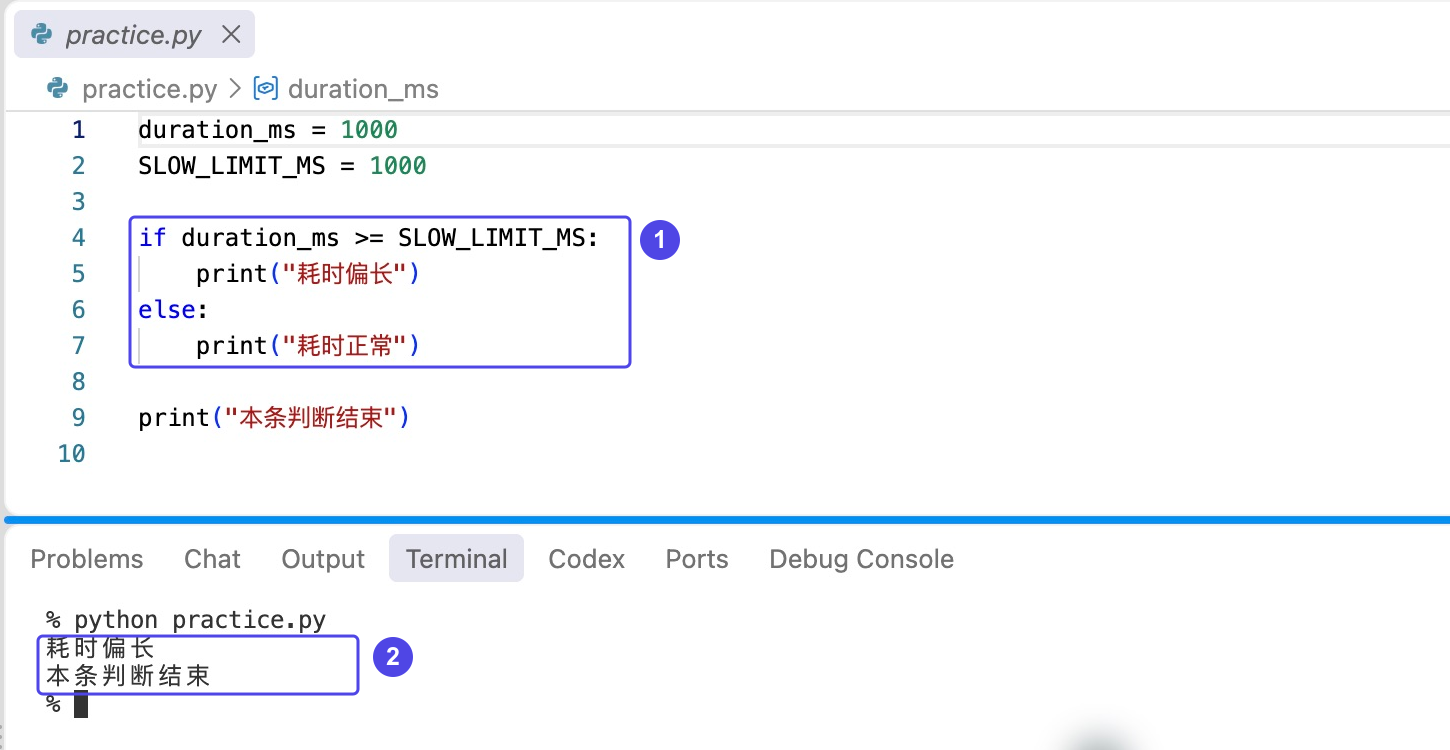
图 01 ① 条件和缩进决定执行哪个分支;② 选中分支后,仍继续执行分支外的输出。
手机上可左右滑动;点击图片可以查看完整图完成后应看到
1000 毫秒得到“耗时偏长”。
把相等边界说清楚
只修改 duration_ms,每次保存后重新运行。
- 分别填入 999、1000、1001,得到“耗时正常、耗时偏长、耗时偏长”。
- 指出哪一行决定是否包含相等,说明为什么不能随意把 >= 换成 >。
理解代码,动手运行
按顺序选择日志类别
一条记录只能归入一个类别,先把分类规则写清楚。从两种结果扩展到三种
elif 表示“前面的条件不成立,再判断这个条件”。if/elif/else 从上到下判断,选中第一个成立的分支后,就跳过后续分支。else 接住前面条件都不成立的情况。
本课的规则是:ERROR 先归为“错误事件”;其余记录中,WARN 或耗时达到 1000 毫秒,归为“需要关注”;剩余归为“一般记录”。这是本次练习的分类规则,原来的日志级别不会因此被改写。
把条件一步步算成 True 或 False
True 表示条件成立,False 表示不成立。先看下划线,预测这一步的结果,再点击计算。
当前输入log_level = "INFO",duration_ms = 1500
比较运算 ==、>= 的优先级高于 or。or 表示两侧至少有一个为 True。
先比较左侧的级别
本次计算:log_level == "WARN" or duration_ms >= 1000下划线标出这一步关注的部分。
or:至少一个,第 1 步,共 3 步:先比较左侧的级别。计算结果尚未显示。
log_level = "ERROR"
duration_ms = 1500
SLOW_LIMIT_MS = 1000

if log_level == "ERROR":
    category = "错误事件"
elif log_level == "WARN" or duration_ms >= SLOW_LIMIT_MS:
    category = "需要关注"
else:
    category = "一般记录"

print(f"原级别:{log_level},类别:{category}")
完整替换 practice.py。category 保存选中的中文类别,分支结束后只输出一次。
把 True / False 接到分支里
选择一组输入,对照上方程序,跟踪条件求值、分支选择和最终输出。
当前输入log_level = "ERROR",duration_ms = 1500,SLOW_LIMIT_MS = 1000
从 if 开始,选中第一个成立的分支后,跳过后面的分支。
先计算 if 的条件
if 本次计算:log_level == "ERROR":下划线标出这一步关注的部分。
ERROR · 1500 毫秒,第 1 步,共 2 步:先计算 if 的条件。计算结果尚未显示。
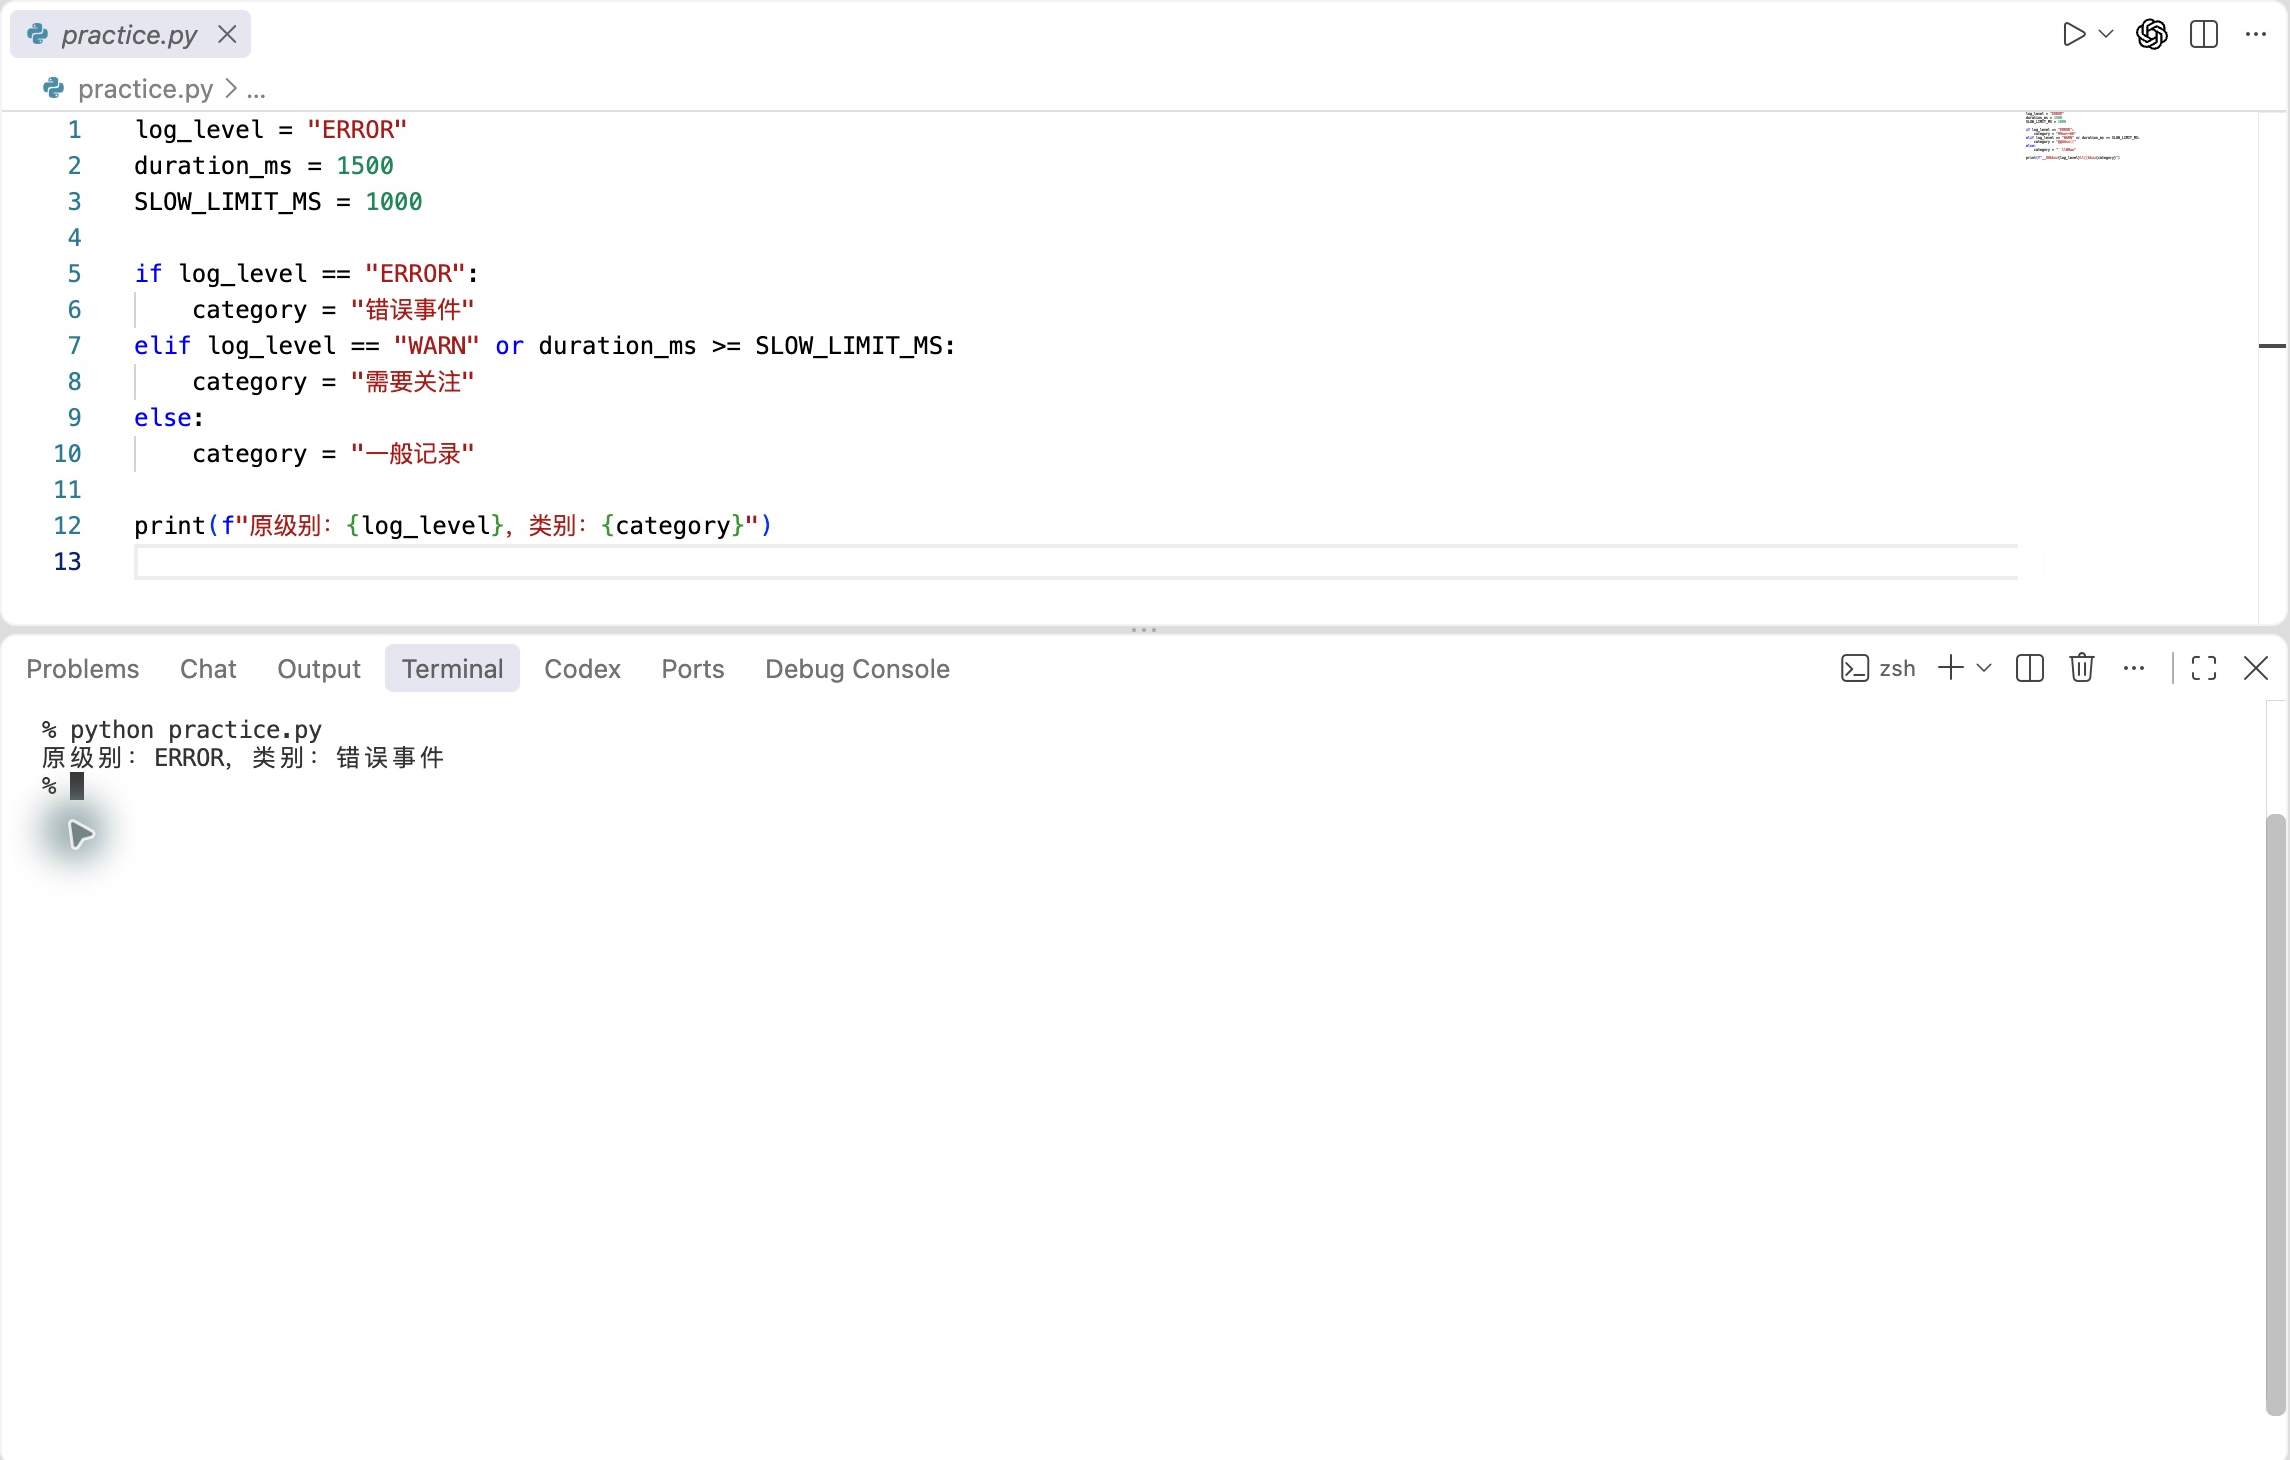
运行 practice.py,对照输出:① ERROR 条件先成立,后面的 elif 不再判断;② 原级别保留,只得到“错误事件”一个类别。
手机上可左右滑动;点击图片可以查看完整图用不同输入走到三个分支
每次只改变级别与耗时,先预测,再运行。
- WARN、125 毫秒应得到“需要关注”;说明 or 的哪一侧为 True。
- INFO、999 毫秒应得到“一般记录”;说明为什么会执行 else。
- 保留 ERROR 优先的顺序,解释为什么两个独立的 if 不等同于 if/elif。
理解代码,动手运行
把一组耗时依次取出来
列表负责保存多项数据,for 负责逐项执行相同的操作。列表与下标
列表把一组有顺序的元素放在方括号中,元素之间用逗号分开,例如 [125, 1500, 999]。一个元素就是其中的一项数据。下标是元素的位置编号,从 0 开始:durations[0] 取第一项,durations[1] 取第二项。
列表可以增加或修改元素。durations[1] = 1000 会替换第二项;durations.append(1001) 会在末尾加一项。append 是列表提供的方法,写在列表名称后,用圆括号给出要追加的值,执行到这一行才发生追加。
for 怎样反复执行
for duration_ms in durations: 表示依次从列表取一个元素,交给变量 duration_ms,再执行下面缩进的代码。全部元素各处理一次,叫作遍历。每处理一个元素是一轮;本轮结束后才取下一个,列表用完就离开循环。
这里的 in 连接“当前元素的名字”和“要遍历的列表”。这里先让循环只输出当前元素,duration_ms 每一轮都会换成下一个值。下一模块再加入条件与计数。
durations = [125, 1500, 999, 1000]

print(f"第一个耗时:{durations[0]} ms")
for duration_ms in durations:
    print(f"当前耗时:{duration_ms} ms")

print("所有耗时已读完")
完整替换 practice.py,for 里的 print 缩进四格;循环结束后的 print 与 for 对齐。
沿着四轮输出读代码
- 01
观察循环变量的变化
这样做运行程序,把四行以“当前耗时”开头的输出与列表元素逐一对应。指出循环前后两条提示为何只出现一次。
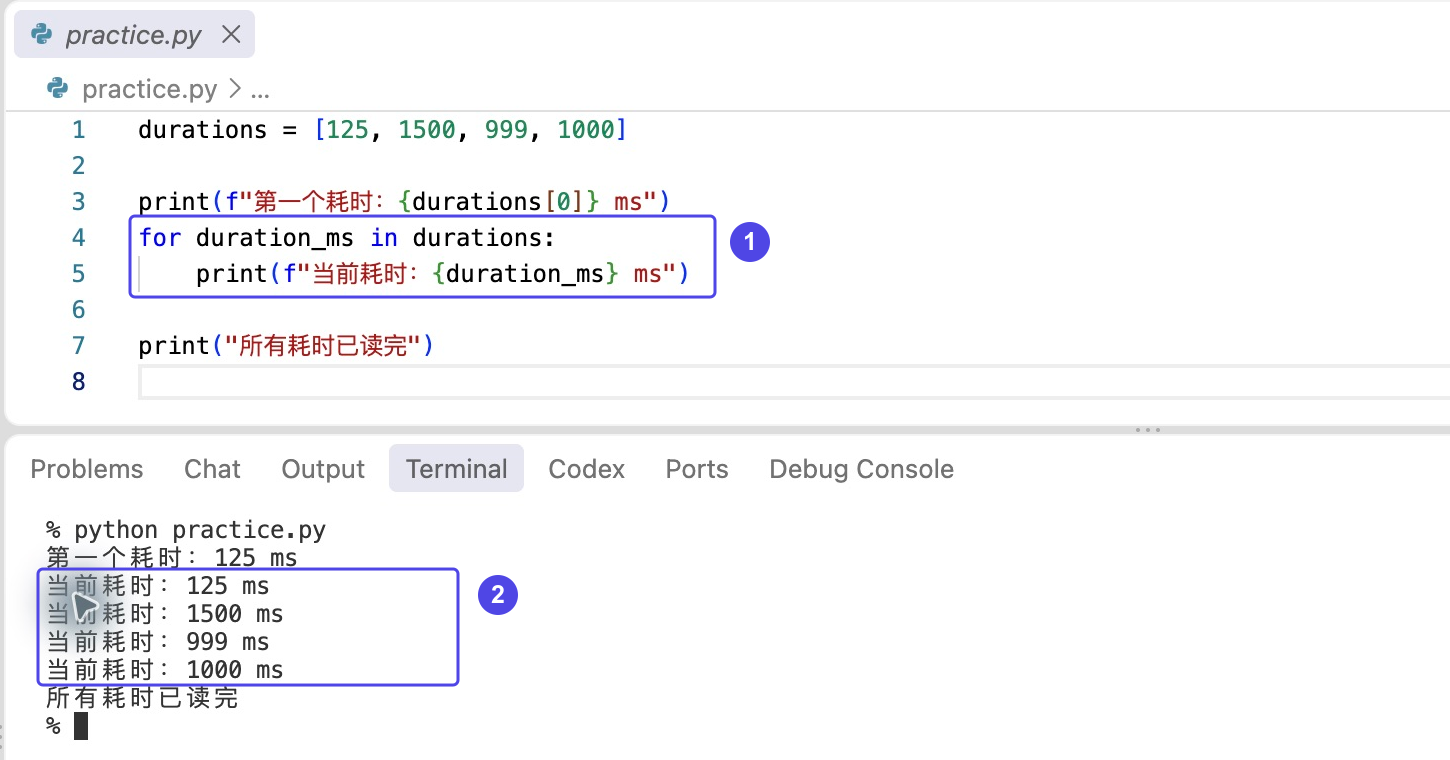
图 03 ① for 每轮取得一个值;② 四个元素依次产生四行“当前耗时”输出。
手机上可左右滑动;点击图片可以查看完整图完成后应看到
125、1500、999、1000 各读取一次,输出顺序与列表一致。
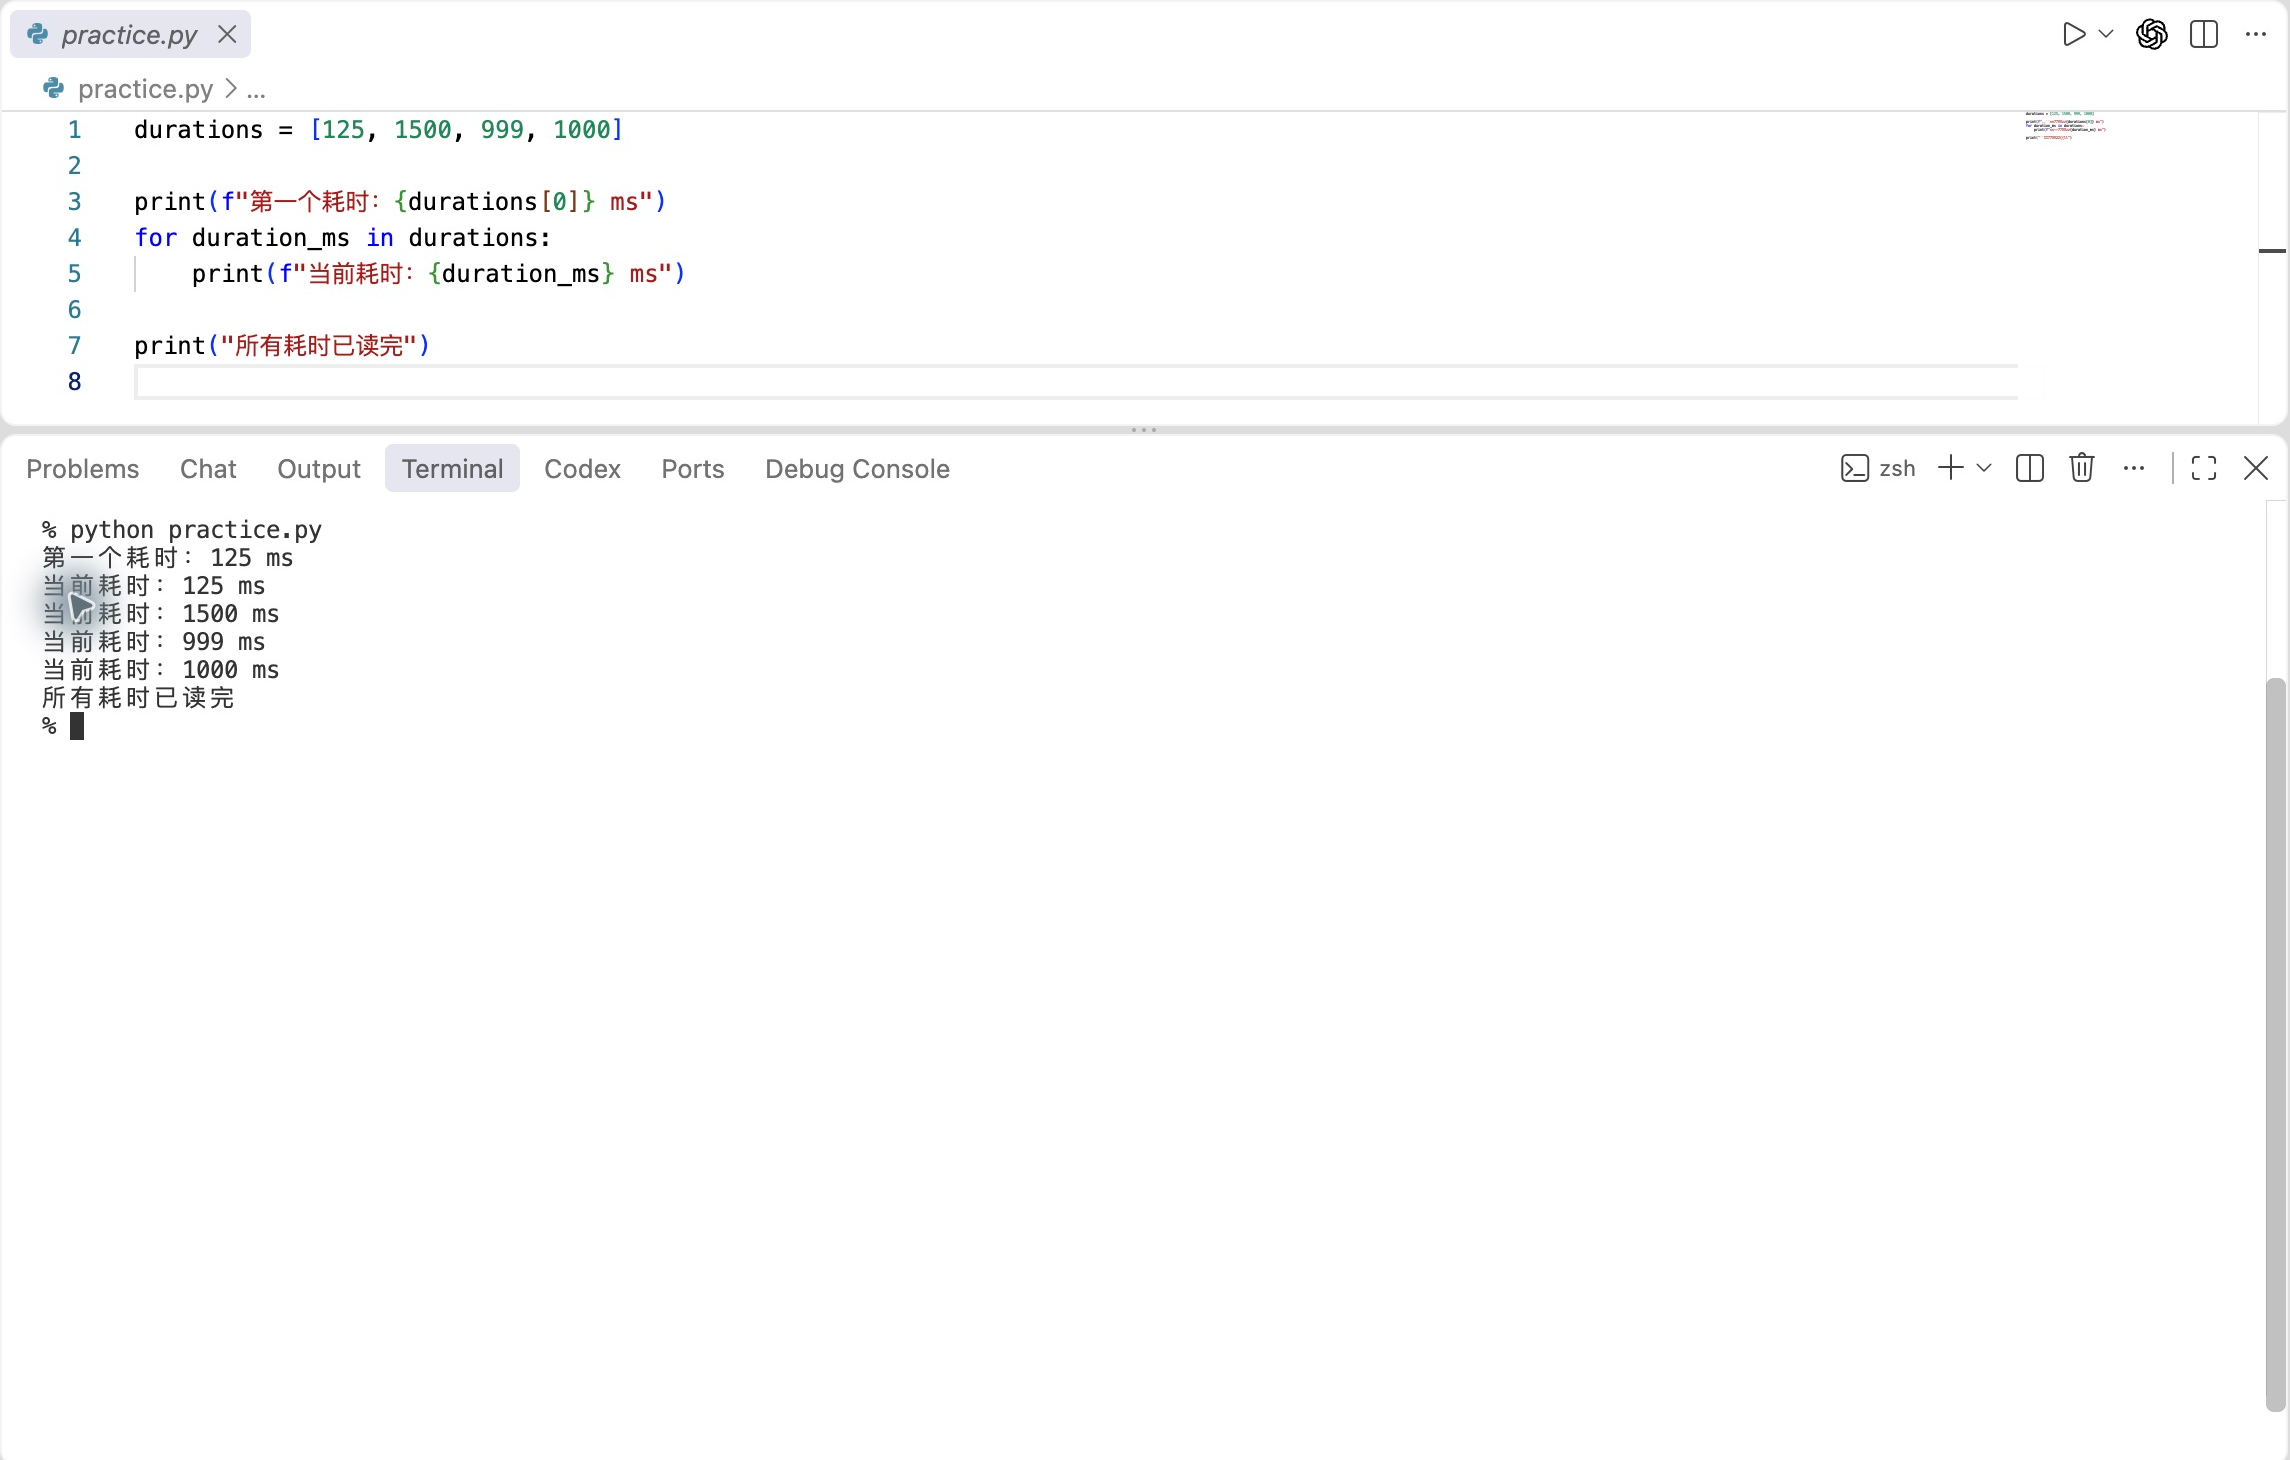
追加一个元素,让循环多走一轮
在列表赋值之后、for 之前加入 durations.append(1001)。
- 运行后应有五条逐项结果,最后一条为 1001 毫秒。
- 将下标为 1 的元素改为 800,重新运行,确认只改变第二项的数值。
理解代码,动手运行
让计数跨过每一轮循环
需要统计整组数据时,先建立计数,再在符合条件时累加。用一个变量保留累计数量
slow_count = 0 给计数变量一个初值,这叫初始化。遇到符合条件的耗时,用 slow_count += 1 把原值加 1 后再赋回。下一轮沿用这个计数,继续累计。
durations = [125, 1500, 999, 1000]
SLOW_LIMIT_MS = 1000
slow_count = 0

for duration_ms in durations:
    if duration_ms >= SLOW_LIMIT_MS:
        slow_count += 1
    print(f"读到 {duration_ms} ms,累计 {slow_count} 条耗时偏长")

print(f"耗时偏长:{slow_count} 条")
完整替换 practice.py。for 内的 if 缩进四格,if 内的累加再缩进一层,共八格;逐轮 print 退回四格,因此每轮都会输出。
跟着循环,一步一步执行
对照上方完整程序,先看当前语句,再点击执行。下方只显示已经得到的值和输出。
durations阈值 1000 毫秒12515009991000
尚未取值
- 取值
- 判断
- 计数
- 输出
循环前,把计数设为 0
当前语句长代码可左右滑动
第 1 行:durations = [125, 1500, 999, 1000]第 2 行:SLOW_LIMIT_MS = 1000第 3 行:slow_count = 0
这一步之前
duration_ms- 尚未取值
- 本轮条件
- 未判断
slow_count- 未初始化
已产生的输出
尚未产生输出
四个耗时,循环开始前,步骤 1,共 19 步:循环前,把计数设为 0。当前显示这一步之前的状态。
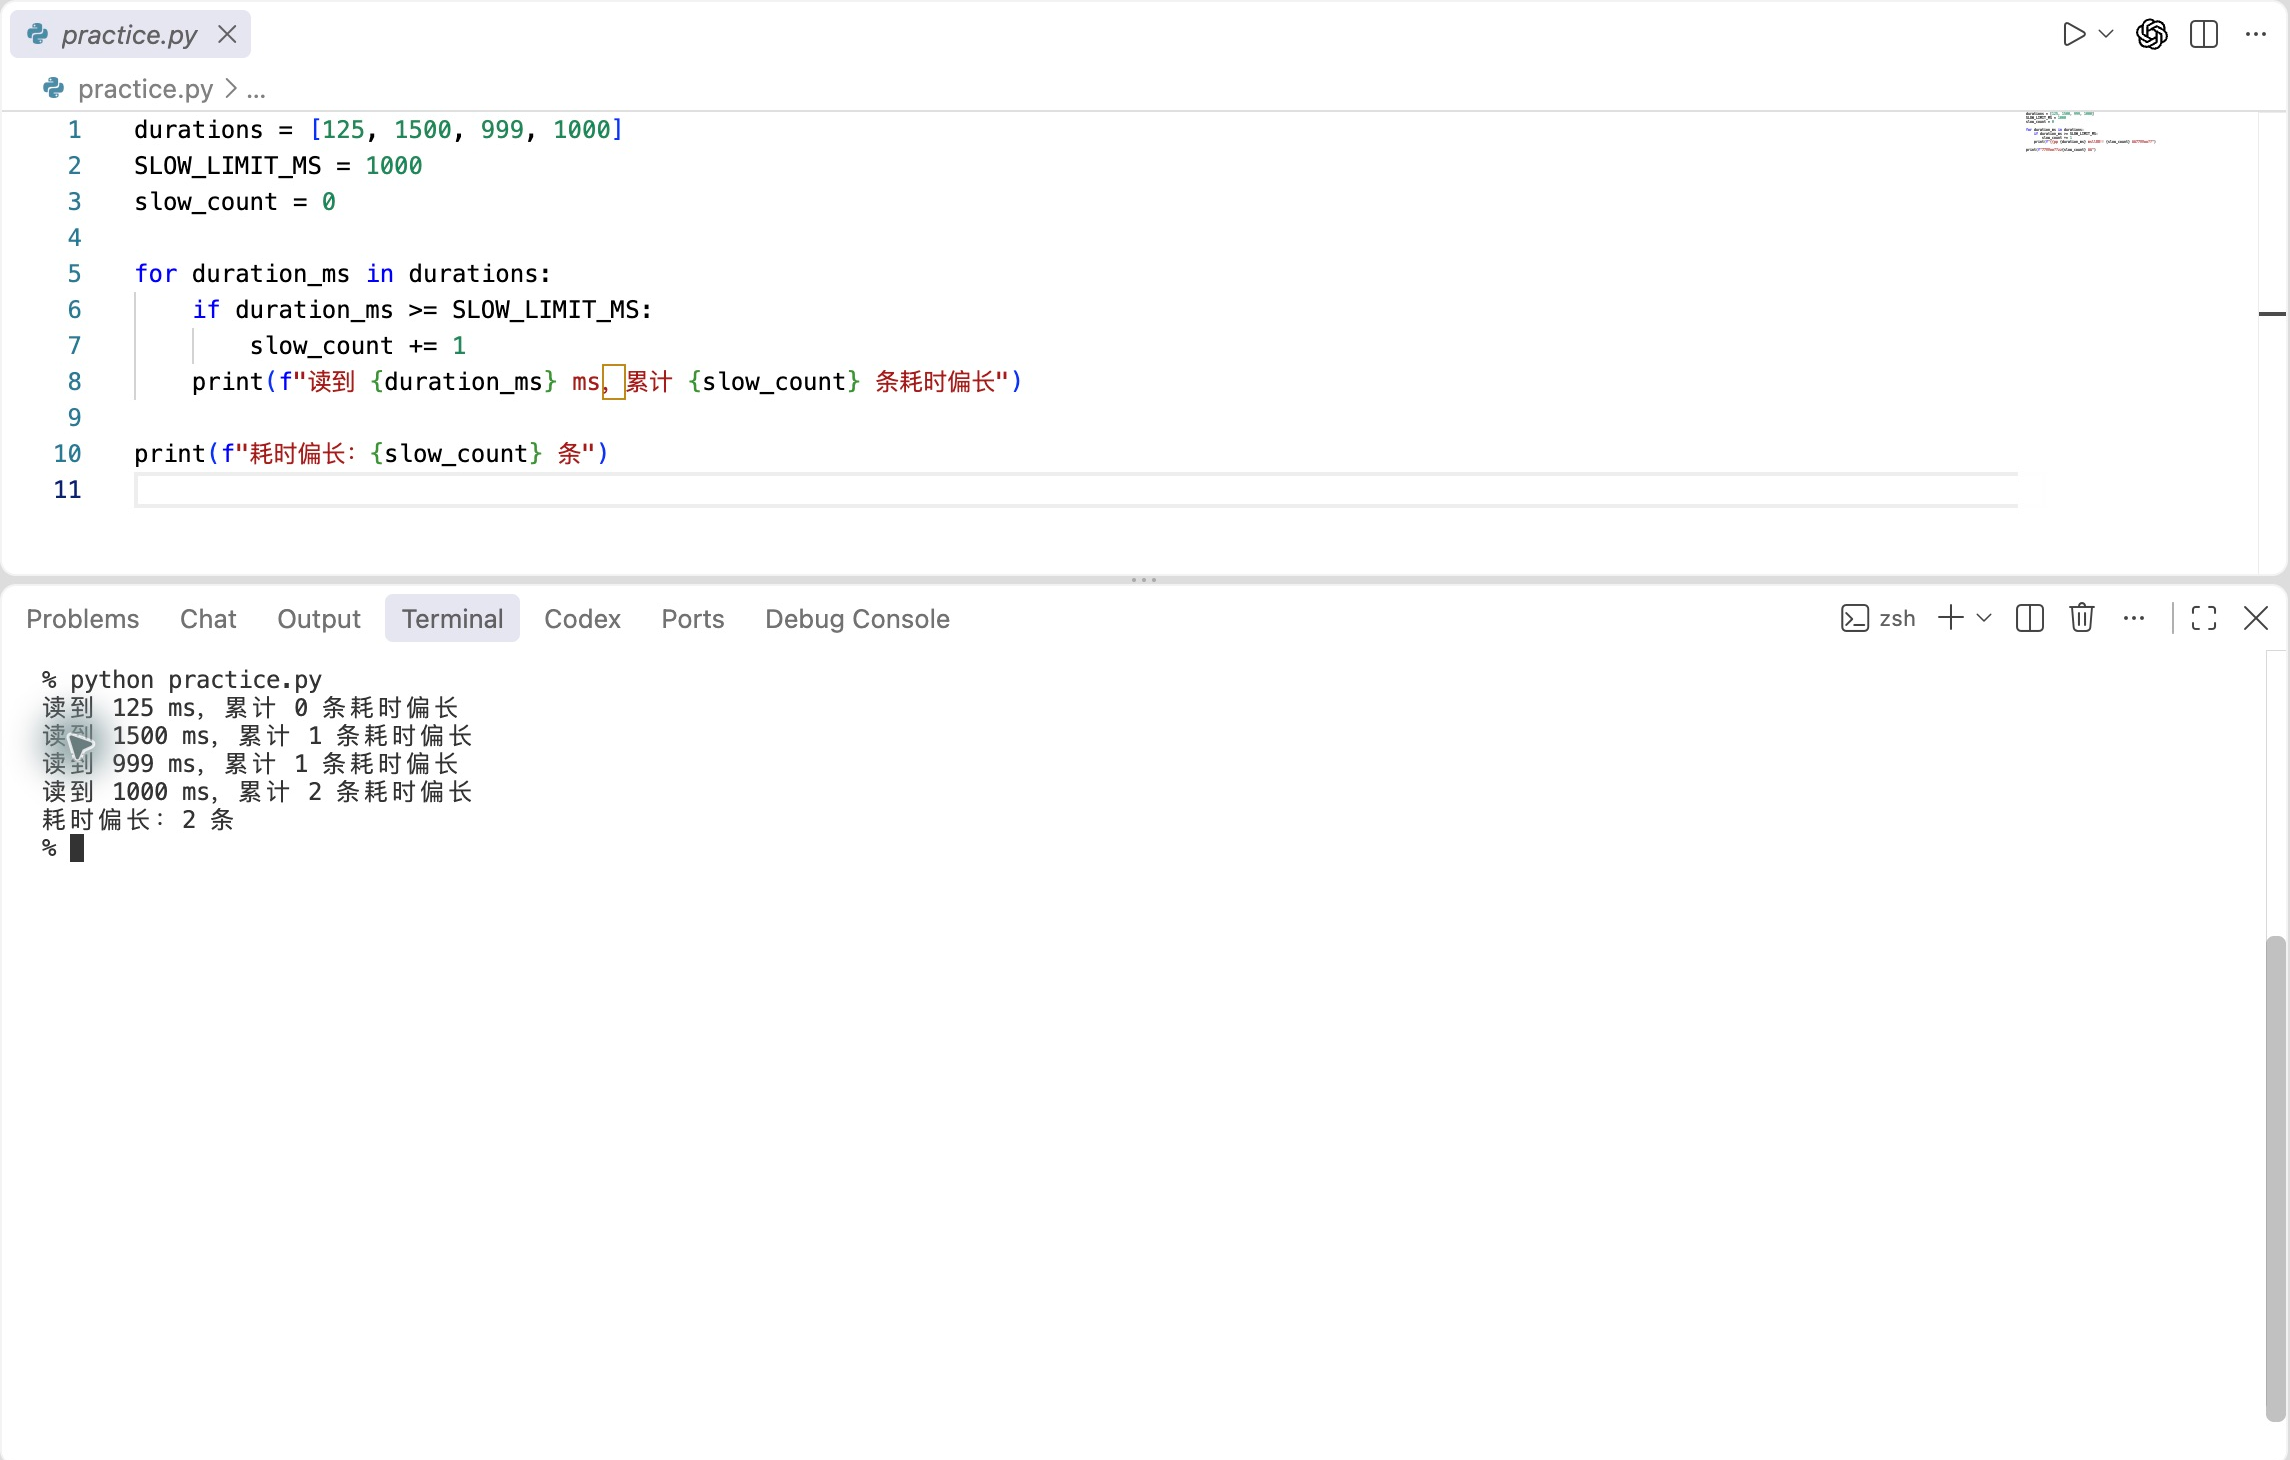
保存并运行 practice.py,将终端的四行逐轮输出和最后一行汇总,与上方演示对应。
手机上可左右滑动;点击图片可以查看完整图修正每轮清零的问题
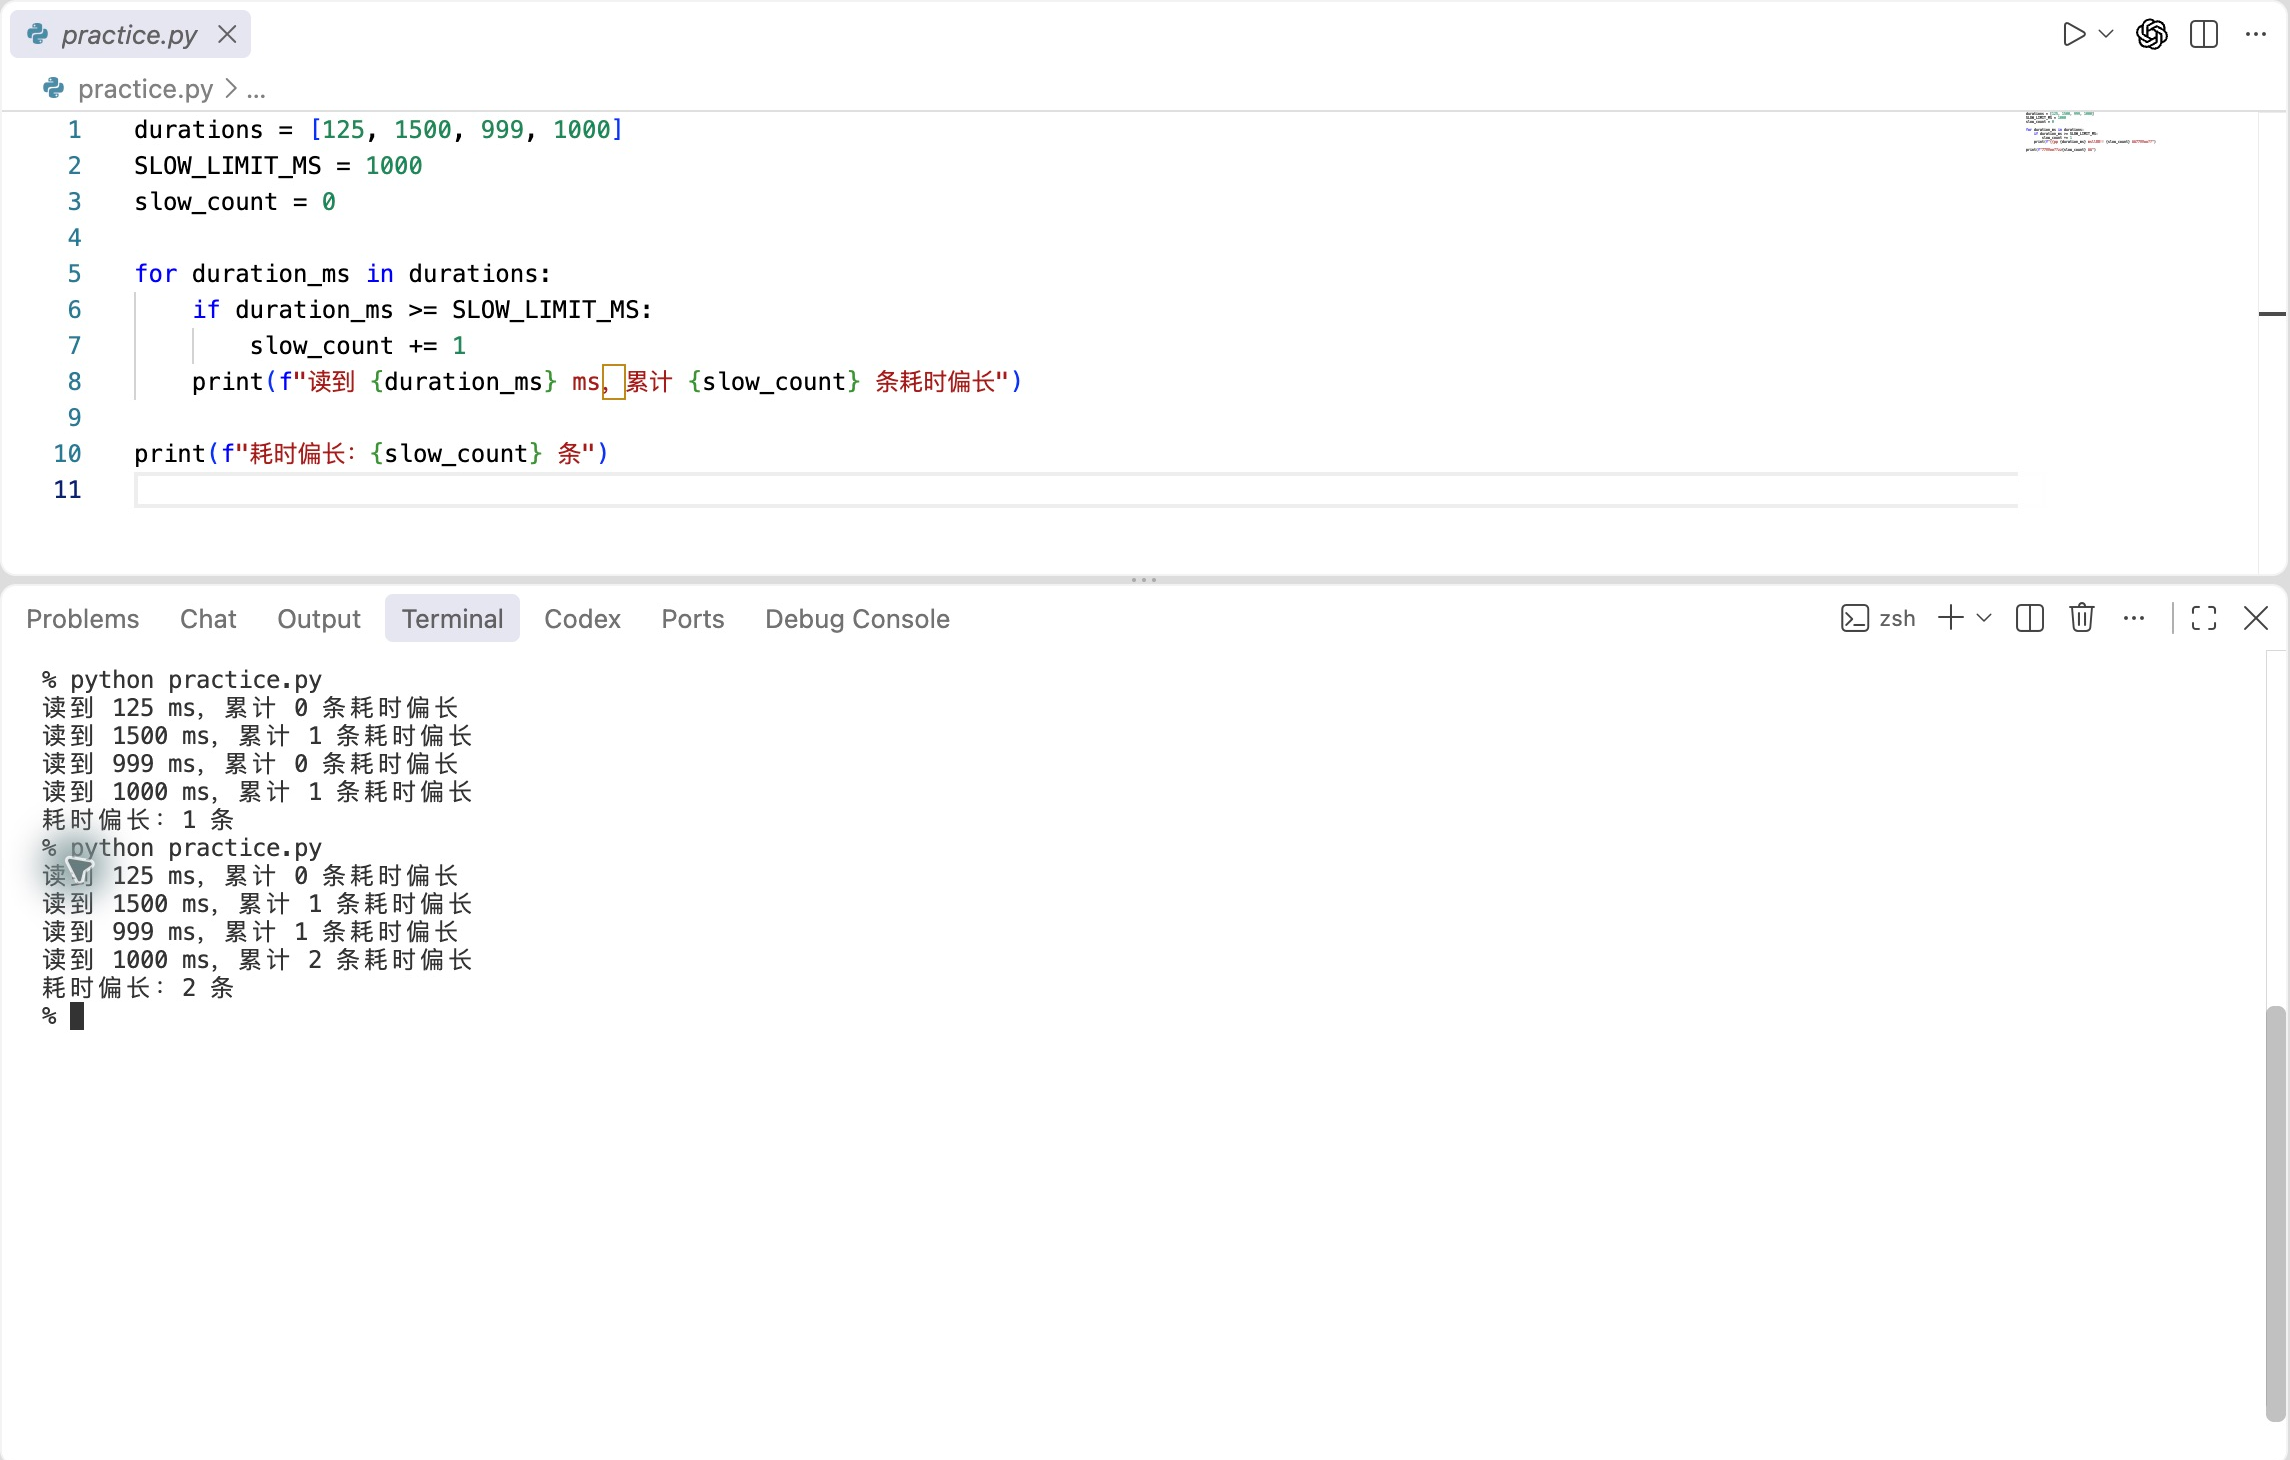
- 01
比较初始化放在循环内外的结果
这样做暂时把 slow_count = 0 移到 for 内部、if 之前,每轮先清零,再运行。确认最终数量变为 1 后,把这行移回 for 之前,用相同数据重新运行。
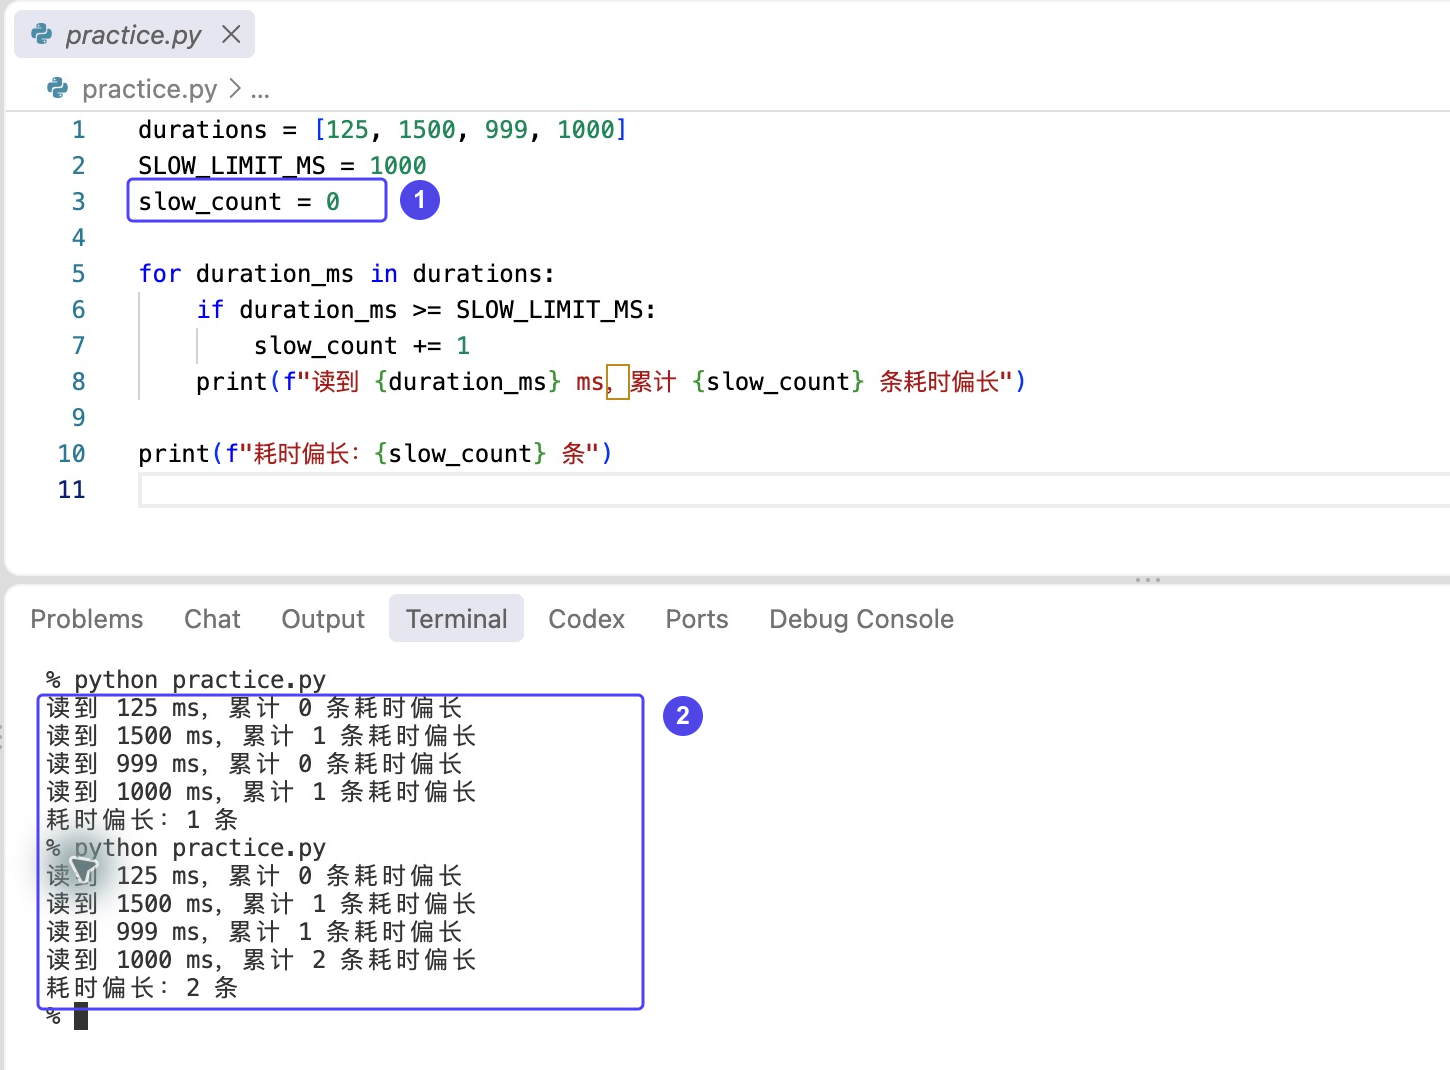
图 05 ① 初始化已移回循环外;② 上一次运行得到 1,修正后用相同数据再次运行得到 2。
手机上可左右滑动;点击图片可以查看完整图完成后应看到
错误写法最后只有 1,修正后为 2。
让一项数据改变统计结果
把列表中的 999 改为 1000,其余代码保持不变。
- 先写出四轮计数,再运行程序;最终数量应从 2 变为 3。
- 指出哪一轮的条件和计数发生变化,解释 >= 为什么包含相等。完成后恢复 999。
理解代码,动手运行
把六项信息放在同一条日志里
耗时之外还要读取级别和设备,字典用名称把相关信息组织在一起。一个键对应一个值
字典写在花括号中,用“键: 值”保存一项信息,各项之间用逗号分隔。键是查找信息的名字;值是实际内容。例如 "device": "switch-01" 中,"device" 是键,"switch-01" 是值。
读取 record["duration_ms"] 时,Python 按这个键找耗时,不按第几项查找。同一个字典中的键不能重复;修改值可以写 record["duration_ms"] = 1000。字典里的冒号连接键和值,不表示后面开始缩进代码块。
record = {
    "timestamp": "2026-09-19 09:00:00",
    "log_level": "INFO",
    "source_ip": "192.0.2.10",
    "device": "switch-01",
    "event": "LINK_UP",
    "duration_ms": 125,
}

log_level = record["log_level"]
device = record["device"]
duration_ms = record["duration_ms"]
print(f"设备:{device},级别:{log_level},耗时:{duration_ms} ms")
完整替换 practice.py。六个键沿用上一课的时间、级别、IP、设备、事件和耗时。
按名称取得需要的信息
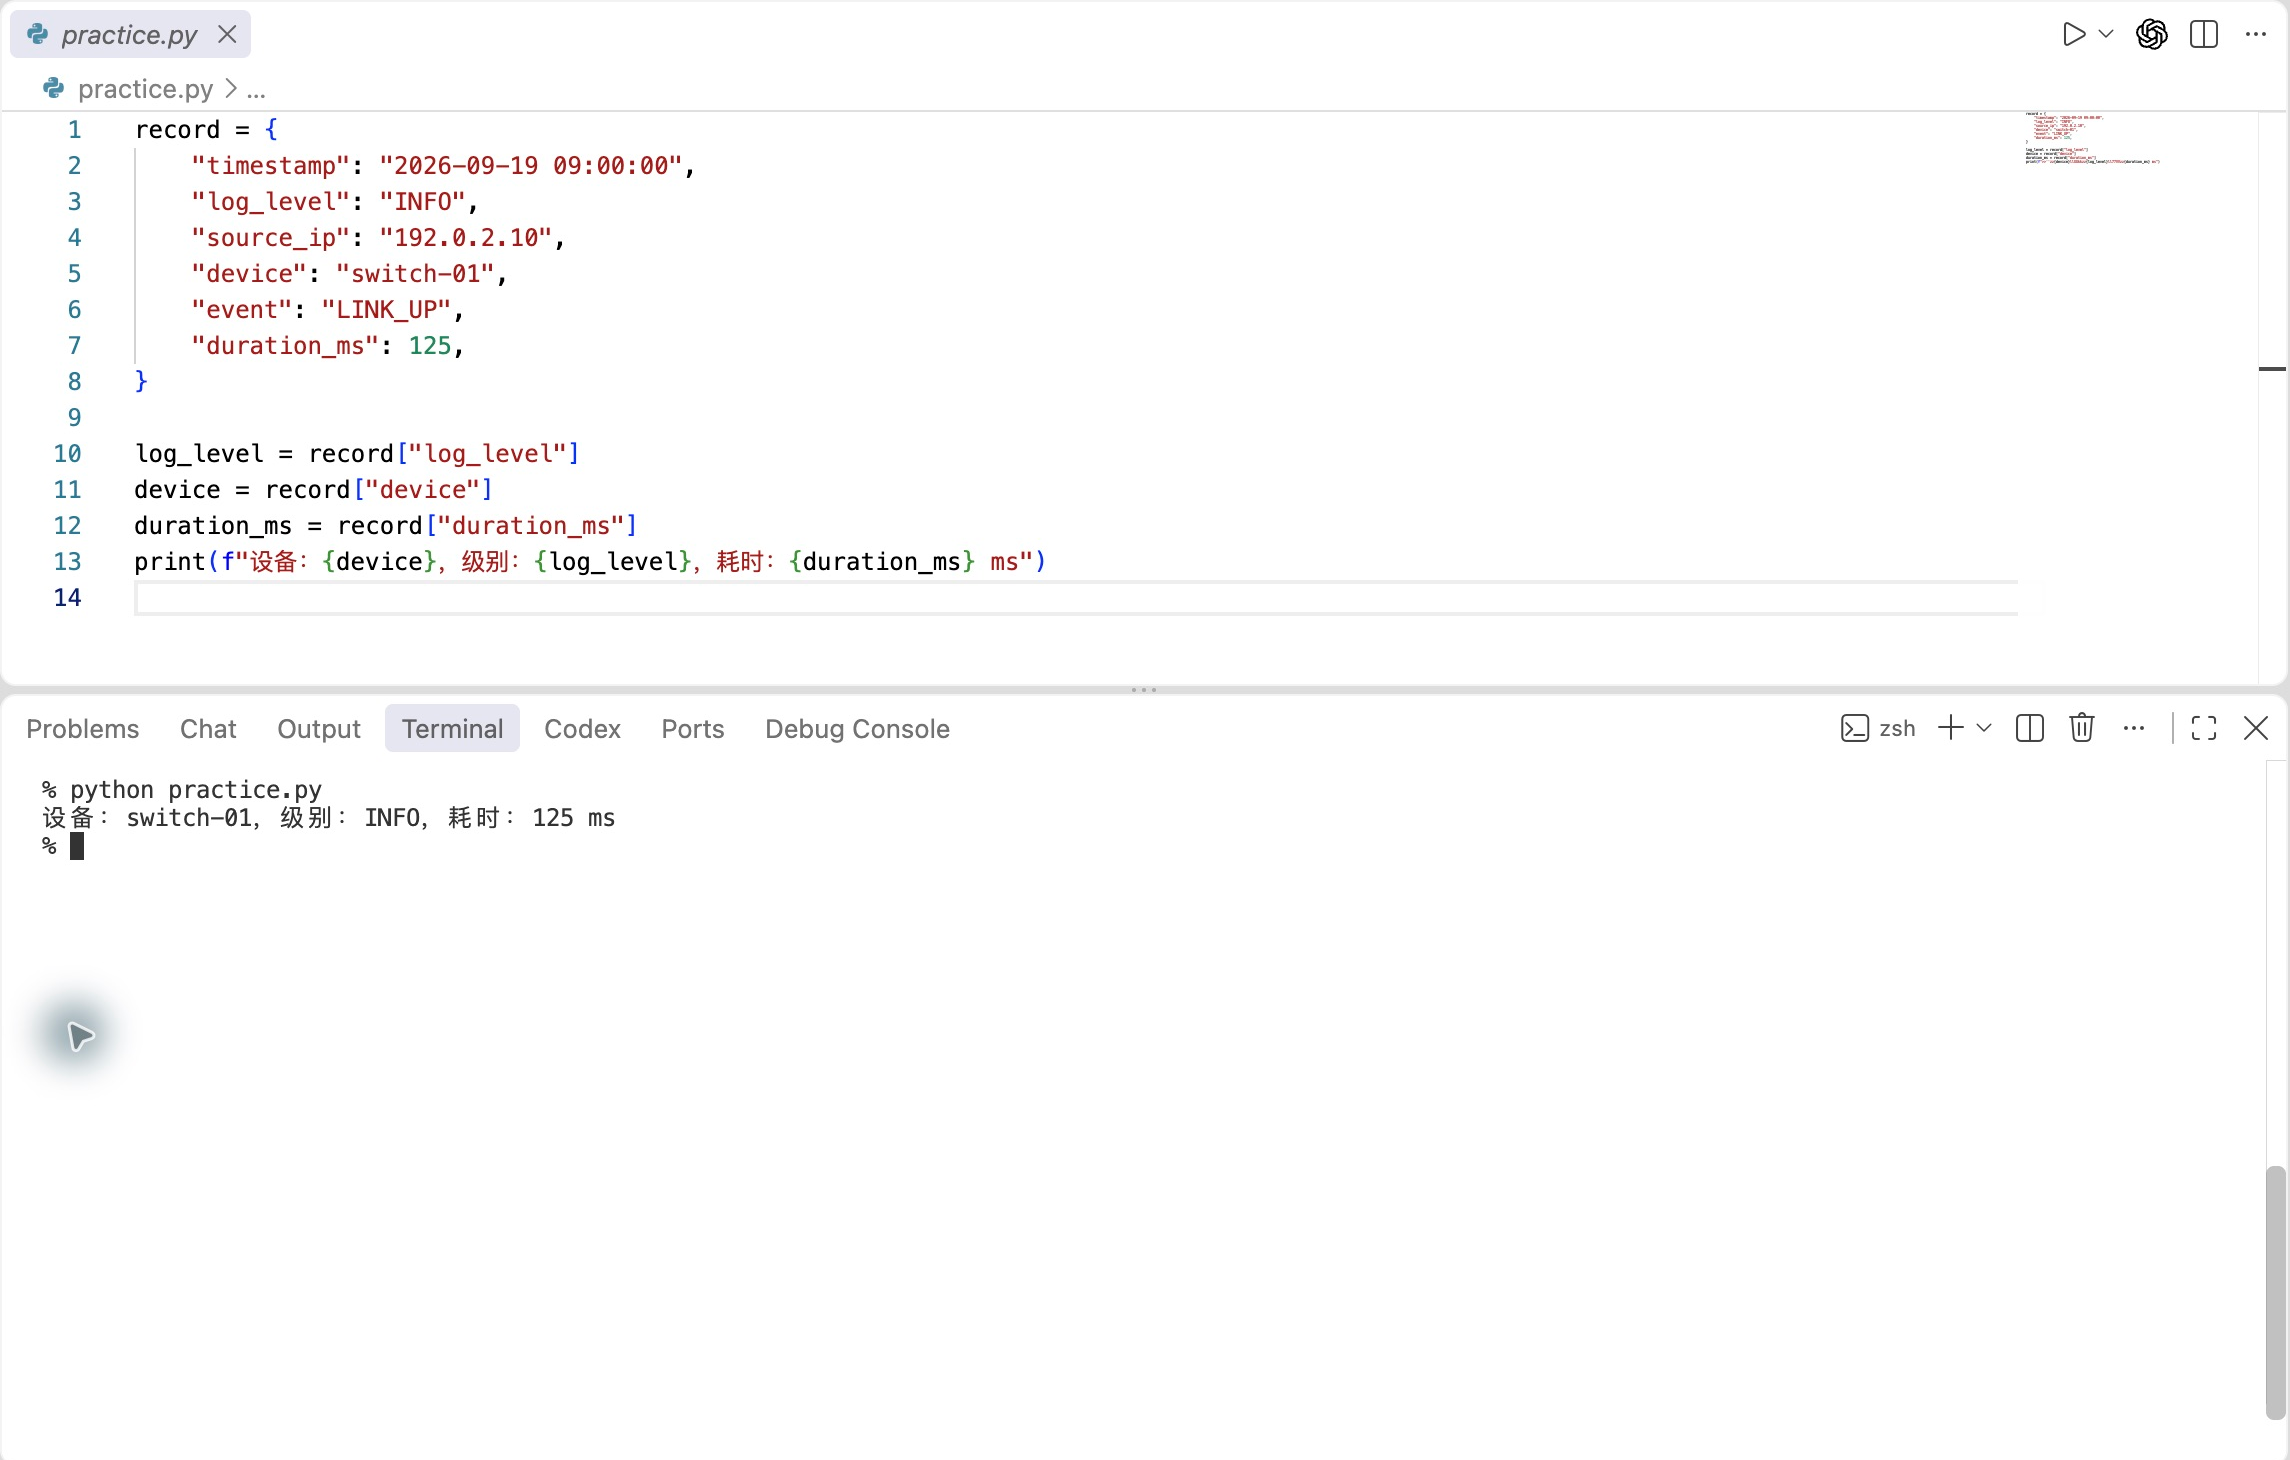
- 01
找到键,再读值
这样做运行程序,对照字典找到每一项输出的来源。将 duration_ms 对应的数值改为 1000,再运行一次。
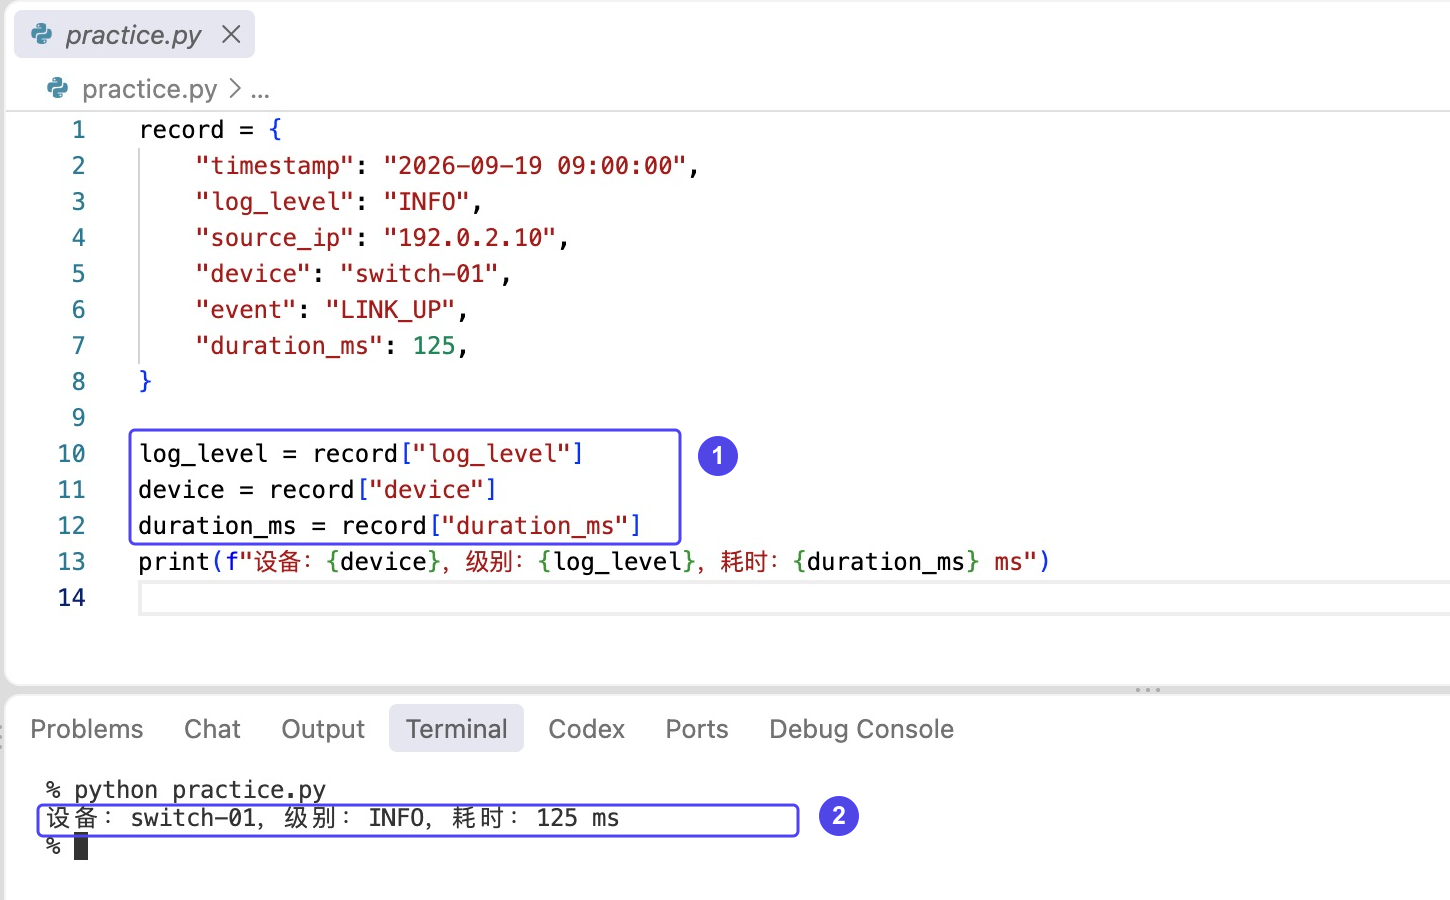
图 06 ① 方括号里用键读取信息;② 设备、级别与耗时来自对应的键值。
手机上可左右滑动;点击图片可以查看完整图完成后应看到
耗时输出随数值改变;其他信息保持原值。
外层列表保存多条,内层字典保存一条
将多个日志字典放入列表,records 就保存了一组记录。for record in records 每轮取出一个完整字典;进入循环后,再通过 record["log_level"] 等写法取得这一条的信息。records[0] 是第一条日志,records[0]["device"] 是第一条日志的设备名称。
先沿蓝色箭头取得第一条日志,再沿橙色箭头取得它的耗时。
手机上可左右滑动;点击图片可以查看完整图records = [
{"timestamp": "2026-09-19 09:00:00", "log_level": "INFO",
"source_ip": "192.0.2.10", "device": "switch-01",
"event": "LINK_UP", "duration_ms": 125},
{"timestamp": "2026-09-19 09:00:00", "log_level": "WARN",
"source_ip": "192.0.2.10", "device": "switch-01",
"event": "HIGH_LATENCY", "duration_ms": 1500},
{"timestamp": "2026-09-19 09:00:00", "log_level": "ERROR",
"source_ip": "192.0.2.10", "device": "switch-01",
"event": "LOGIN_FAILED", "duration_ms": 0},
]
for record in records:
device = record["device"]
log_level = record["log_level"]
duration_ms = record["duration_ms"]
print(f"{device},{log_level},{duration_ms} ms")完整替换 practice.py。先看外层方括号,再看其中三个花括号;每个花括号都保存同样的六个键。
跟踪一轮里的取值顺序
- 01
先取一条,再取这条的字段
这样做运行程序,逐条指出 record 当前是哪一个字典,以及本轮输出来自哪些键。不要将三条日志的级别与耗时交叉配对。
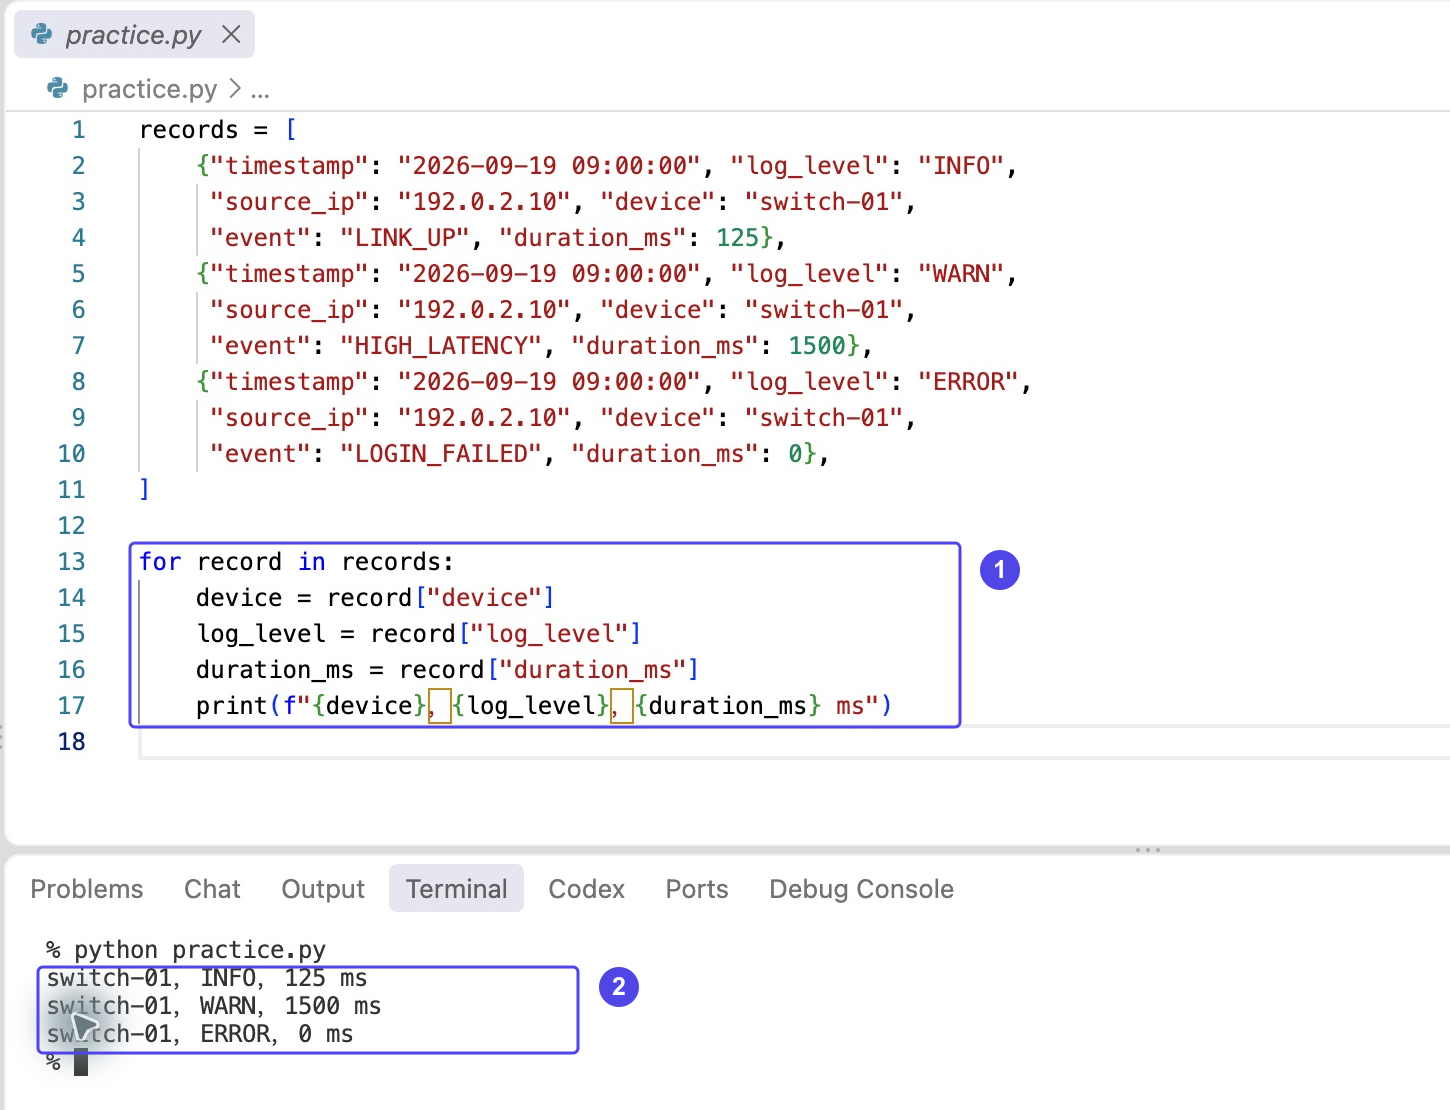
图 07 ① 每轮先取得一个完整字典,再读取它的值;② 三条输出分别对应三条日志。
手机上可左右滑动;点击图片可以查看完整图完成后应看到
输出三条日志,各条的级别、设备、耗时与对应字典一致。
增加一条自己的记录
复制一个完整字典,加在 records 列表末尾,注意字典之间的逗号。
- 保留六个键,将新记录设为 INFO、1000 毫秒,设备名称改为 switch-02。
- 运行后应有四条输出,最后一条显示新设备和新耗时。
理解代码,动手运行
跳过本轮,还是结束循环
先用相同数据比较 continue 与 break,再把 continue 用到日志过滤中。只改一个词,程序会走向哪里
continue 跳过当前这一轮剩余的语句,回到 for 取下一项;break 直接结束当前这层循环。它们都写在循环内部,执行到这一行时才改变去向。
durations = [125, 1500, 999, 1000]
SLOW_LIMIT_MS = 1000

for duration_ms in durations:
    if duration_ms >= SLOW_LIMIT_MS:
        continue
    print(f"处理 {duration_ms} ms")

print("循环之后")
完整替换 practice.py。先运行 continue 版本;第二次只把第 6 行的 continue 改成 break,其余数据、条件与输出语句保持相同。
同一组数据,两种循环去向
两边只有第 6 行不同。一起逐步执行,比较当前值、下一步去向与已经产生的输出。
duration_ms >= 1000continue
跳过本轮,接着取值125待取1500待取999待取1000待取
准备同一组数据
第 1 行:durations = [125, 1500, 999, 1000]第 2 行:SLOW_LIMIT_MS = 1000
- 当前值
- 尚未取值
- 条件
- 未判断
- 循环状态
- 尚未开始
已产生的输出
尚未产生输出
break
离开循环,不再取值125待取1500待取999待取1000待取
准备同一组数据
第 1 行:durations = [125, 1500, 999, 1000]第 2 行:SLOW_LIMIT_MS = 1000
- 当前值
- 尚未取值
- 条件
- 未判断
- 循环状态
- 尚未开始
已产生的输出
尚未产生输出
对照步骤 1,共 15 步。continue:准备同一组数据。显示这一步之前的状态。 break:准备同一组数据。显示这一步之前的状态。
把 continue 用到无效日志上
下面回到完整日志:先判断记录能否使用,再处理有效记录。本课的数据已给出正确的数值和文字类型;级别不是 INFO、WARN、ERROR 之一,或耗时小于 0,都视为无效。valid_levels 保存允许的级别;log_level not in valid_levels 判断这个级别是否不在列表中。
此处的 in 判断成员是否存在,得到 True 或 False;它与 for 中表示遍历的 in 使用位置不同。not in 表示“不在其中”。两个无效条件用 or 连接,任一成立就执行 continue。
records = [
    {"timestamp": "2026-09-19 09:00:00", "log_level": "INFO",
     "source_ip": "192.0.2.10", "device": "switch-01",
     "event": "LINK_UP", "duration_ms": 125},
    {"timestamp": "2026-09-19 09:04:00", "log_level": "UNKNOWN",
     "source_ip": "192.0.2.12", "device": "router-01",
     "event": "LINK_UP", "duration_ms": 125},
    {"timestamp": "2026-09-19 09:00:00", "log_level": "WARN",
     "source_ip": "192.0.2.10", "device": "switch-01",
     "event": "HIGH_LATENCY", "duration_ms": 1500},
    {"timestamp": "2026-09-19 09:05:00", "log_level": "INFO",
     "source_ip": "192.0.2.10", "device": "switch-01",
     "event": "LINK_UP", "duration_ms": -1},
]

valid_levels = ["INFO", "WARN", "ERROR"]
invalid_count = 0

for record in records:
    log_level = record["log_level"]
    duration_ms = record["duration_ms"]

    if log_level not in valid_levels or duration_ms < 0:
        invalid_count += 1
        print(f"无效记录:{log_level},{duration_ms} ms")
        continue

    print(f"继续处理:{log_level},{duration_ms} ms")

print(f"无效记录:{invalid_count} 条")
完整替换 practice.py。本例使用四条记录观察 continue,先专注于哪些行能够到达最后的 print。
观察跳过与继续的区别
- 01
顺着当前记录走到 continue
这样做运行程序,分别找到未知级别与负耗时的记录。指出它们进入哪条条件,以及哪一行有效记录输出被跳过。
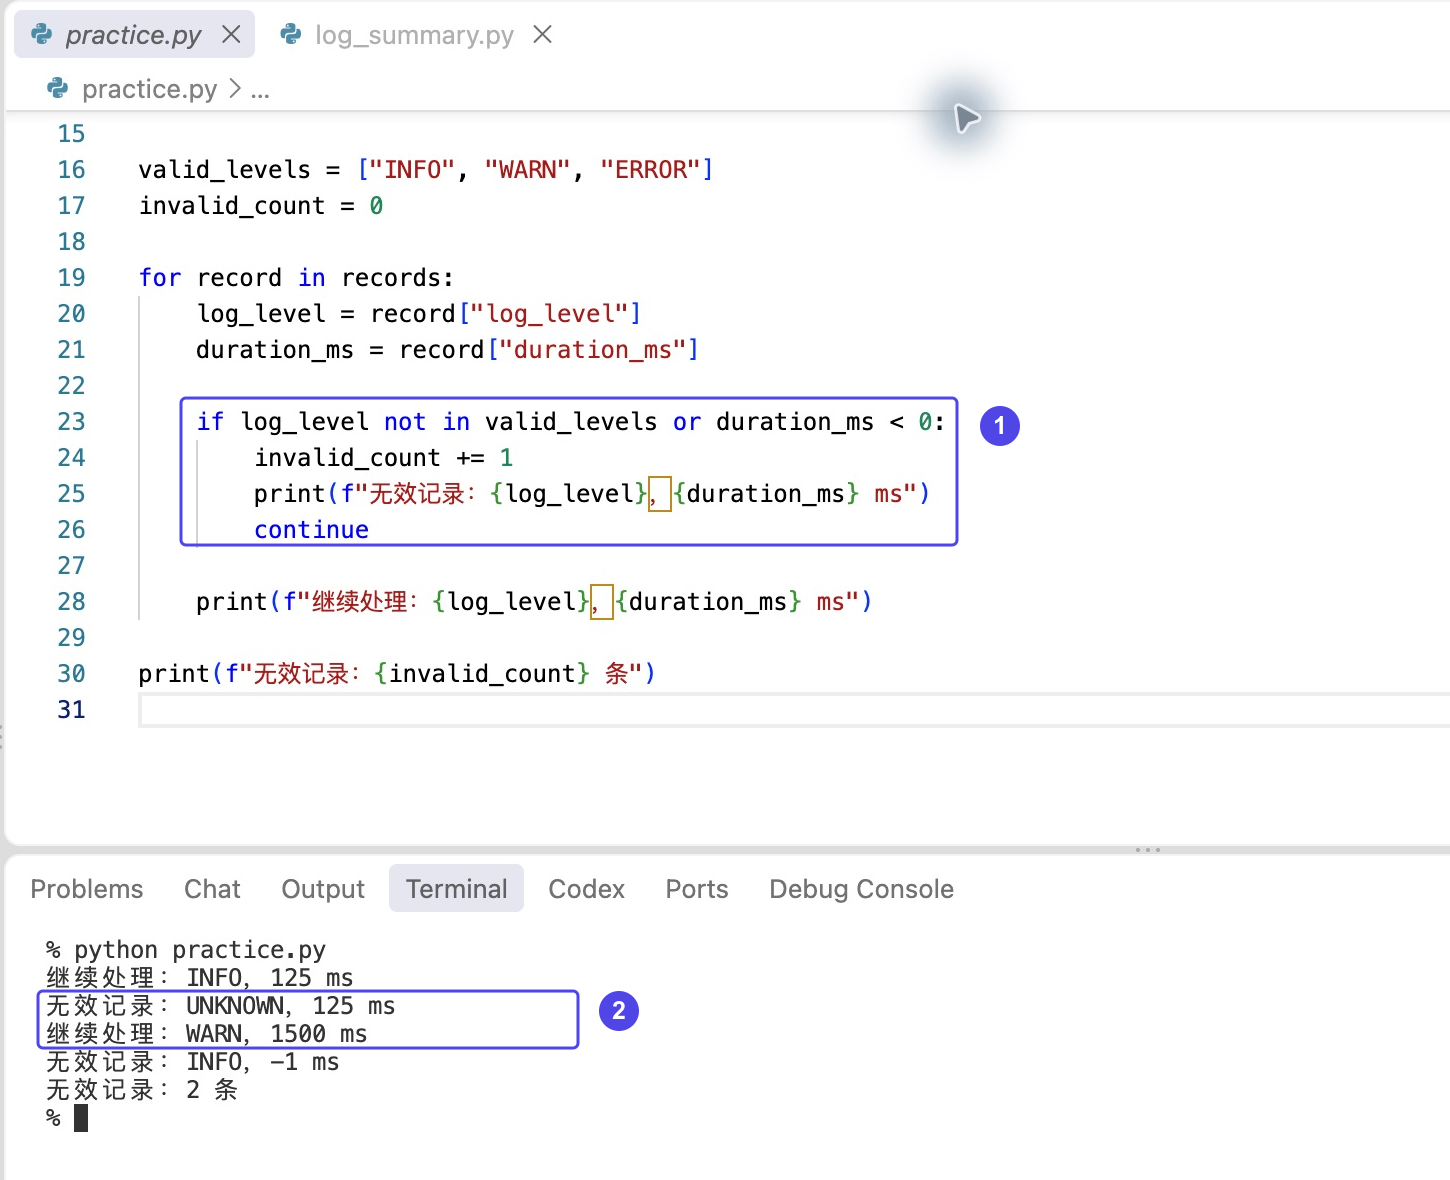
图 08 ① 无效计数后执行 continue;② 跳过 UNKNOWN 后,下一条 WARN 仍显示“继续处理”。
手机上可左右滑动;点击图片可以查看完整图完成后应看到
无效记录得到跳过提示,有效记录仍正常输出。
在无效记录后再放一条有效记录
在列表末尾加入 INFO、125 毫秒的完整日志。
- 运行后,新增日志仍应被输出,说明循环没有整体结束。
- 将未知级别改为 WARN、负耗时改为 0,再运行;这两条记录现在都应通过有效性判断。
理解代码,动手运行
根据停止方式选择循环
已有一组数据用 for;需要重复固定次数或反复判断时,用下面的短例辨别写法。range 给出一串整数
range 是 Python 的内置函数,不需要另外准备文件。range(1, 4) 按顺序提供 1、2、3,不包含终点 4;range(3) 从 0 开始,提供 0、1、2。for 可以逐个取得这些整数,用来重复已知次数的操作。
for number in range(1, 4):
    print(f"第 {number} 次读取日志")
完整替换 practice.py,运行后确认只出现第 1、2、3 次。
while 在每轮开始前重新判断
while 条件: 表示只要条件为 True,就执行缩进的循环体,再回到条件处。与 for 自动取下一个元素不同,while 通常需要自己更新影响条件的变量,否则条件可能永远成立。
remaining = 3

while remaining > 0:
    print(f"还剩 {remaining} 条待处理")
    remaining -= 1

print("全部处理结束")
完整替换 practice.py。先设 remaining 为 3;每轮的 -= 1 表示原值减一再赋回,到 0 时条件为 False。
说明两种循环为什么停下来
依次运行 range 与 while 的完整短例。
- 指出 range(1, 4) 取完了哪些整数,以及 while 在 remaining 变成多少时停止。
- 把 remaining 的初值改成 2,预测输出后再运行。若 while 不停输出,可在终端按 Ctrl+C 停止并检查变量更新。
理解代码,动手运行
选择适合数据用途的容器
最后认识两种短小写法:固定组合用元组,去掉重复项用集合。元组保存不准备改动的组合
元组通常用圆括号写,例如 ("timestamp", "log_level", "duration_ms")。它有顺序,可以按下标读取,但创建后不能追加、删除或替换其中的元素。下面的 field_order 用它保存固定的字段顺序,field_order[0] 取得第一项。只有一个元素时要保留逗号,例如 ("INFO",)。
集合保存不重复的元素。set 是 Python 的内置函数,将设备名称列表交给它,就会去掉重复名称。集合不提供位置下标,输出顺序也不作为结果的一部分;len 是内置函数,返回容器中的元素数量。
field_order = ("timestamp", "log_level", "duration_ms")
device_names = ["switch-01", "switch-02", "switch-01"]
unique_devices = set(device_names)

print(f"固定顺序的第一项:{field_order[0]}")
print(f"设备名称出现 {len(device_names)} 次")
print(f"共有 {len(unique_devices)} 台不同设备")
完整替换 practice.py,运行后比较列表长度与集合长度。
按需要选择
先想清楚要保留位置、按名称查值,还是只关心不重复的内容。
左右滑动表格,可查看完整内容
| 需要什么 | 使用什么 | 本课中的对象 |
|---|---|---|
| 有顺序,保留每一项,可修改 | 列表 list | 整组日志 records |
| 按键查找相关信息 | 字典 dict | 一条日志 record |
| 有顺序,不替换其中元素 | 元组 tuple | 固定的字段顺序 |
| 只保留不重复项 | 集合 set | 出现过哪些设备 |
区分记录数量与设备数量
在设备名称列表中再加一个已有名称,然后重新运行。
- 列表长度增加 1,集合长度不变。
- 再加入一个新设备名称,确认两者的长度都增加 1。解释为什么原始日志列表不能直接用去重结果替代。
理解代码,动手运行
完成日志分类统计程序
把已经学过的步骤按数据准备、初始化、逐条处理、汇总输出连接起来。回到同一个完整任务
log_summary.py 已给出八条日志,每条都有上一课的六项信息;你需要补全后面的处理部分。程序不读取其他文件,也不需要输入。先看下表预测结果,再打开程序。
八条日志应进入哪个类别
A—H 按顺序对应列表中的第 1—8 条。这里只列出判断需要的级别与耗时;下载文件保留全部六项信息。每条只计入一个类别。
左右滑动表格,可查看完整内容
| 记录 | 级别 | 耗时(毫秒) | 应归入 |
|---|---|---|---|
| A | INFO | 125 | 一般记录 |
| B | WARN | 1500 | 需要关注 |
| C | ERROR | 0 | 错误事件 |
| D | INFO | 999 | 一般记录 |
| E | INFO | 1000 | 需要关注 |
| F | ERROR | 1500 | 错误事件 |
| G | UNKNOWN | 125 | 无效记录 |
| H | INFO | -1 | 无效记录 |
下载日志分类起始程序
保存到“第4课”文件夹。保留 records 中的八条日志,只补全后面的计数、循环和输出。
- 打开后先运行一次,确认能看到数据准备提示。
- 接下来编辑 log_summary.py;practice.py 保留为短例练习,不需要拼到这个文件里。
按执行顺序补全同一个程序
- 01
循环前建立四个计数
这样做在八条数据之后,设置允许的级别和 1000 毫秒阈值,将无效、错误、关注、一般四个计数分别初始化为 0。
完成后应看到
所有计数都位于 for 之前。
- 02
每轮先读值,再判断有效性
这样做for 每次取一条 record,通过键读取级别与耗时。若级别不在允许范围或耗时为负,增加无效计数,输出跳过提示,然后 continue。
完成后应看到
无效记录不能到达后面的分类分支。
- 03
为有效记录选择唯一类别
这样做接着写 if/elif/else:ERROR 优先;其余 WARN 或耗时达到阈值时需要关注;剩余为一般记录。每个分支只增加对应计数,再输出当前记录的类别。
完成后应看到
当前记录只让四个计数中的一个增加。
- 04
循环之后输出汇总
这样做移除起始文件末尾的数据准备提示,在 for 之外显示四类数量与总数。全部补全后保存,在终端运行 python log_summary.py;使用 python3 的同学换成 python3。
完成后应看到
四类各为 2,总数为 8,四类数量相加也等于 8。
SLOW_LIMIT_MS = 1000
valid_levels = ["INFO", "WARN", "ERROR"]
normal_count = 0
attention_count = 0
error_count = 0
invalid_count = 0

for record in records:
    log_level = record["log_level"]
    event = record["event"]
    duration_ms = record["duration_ms"]

    if log_level not in valid_levels or duration_ms < 0:
        invalid_count += 1
        print(f"{log_level} | {event} | {duration_ms} ms → 无效记录")
        continue

    if log_level == "ERROR":
        category = "错误事件"
        error_count += 1
    elif log_level == "WARN" or duration_ms >= SLOW_LIMIT_MS:
        category = "需要关注"
        attention_count += 1
    else:
        category = "一般记录"
        normal_count += 1

    print(f"{log_level} | {event} | {duration_ms} ms → {category}")

print(f"总记录:{len(records)} 条")
print(f"一般记录:{normal_count} 条")
print(f"需要关注:{attention_count} 条")
print(f"错误事件:{error_count} 条")
print(f"无效记录:{invalid_count} 条")
先按上面四步自己补全,再逐行对照。保留文件已有的 records,把下面的处理部分放在它之后;不要将记录数据重复添加。
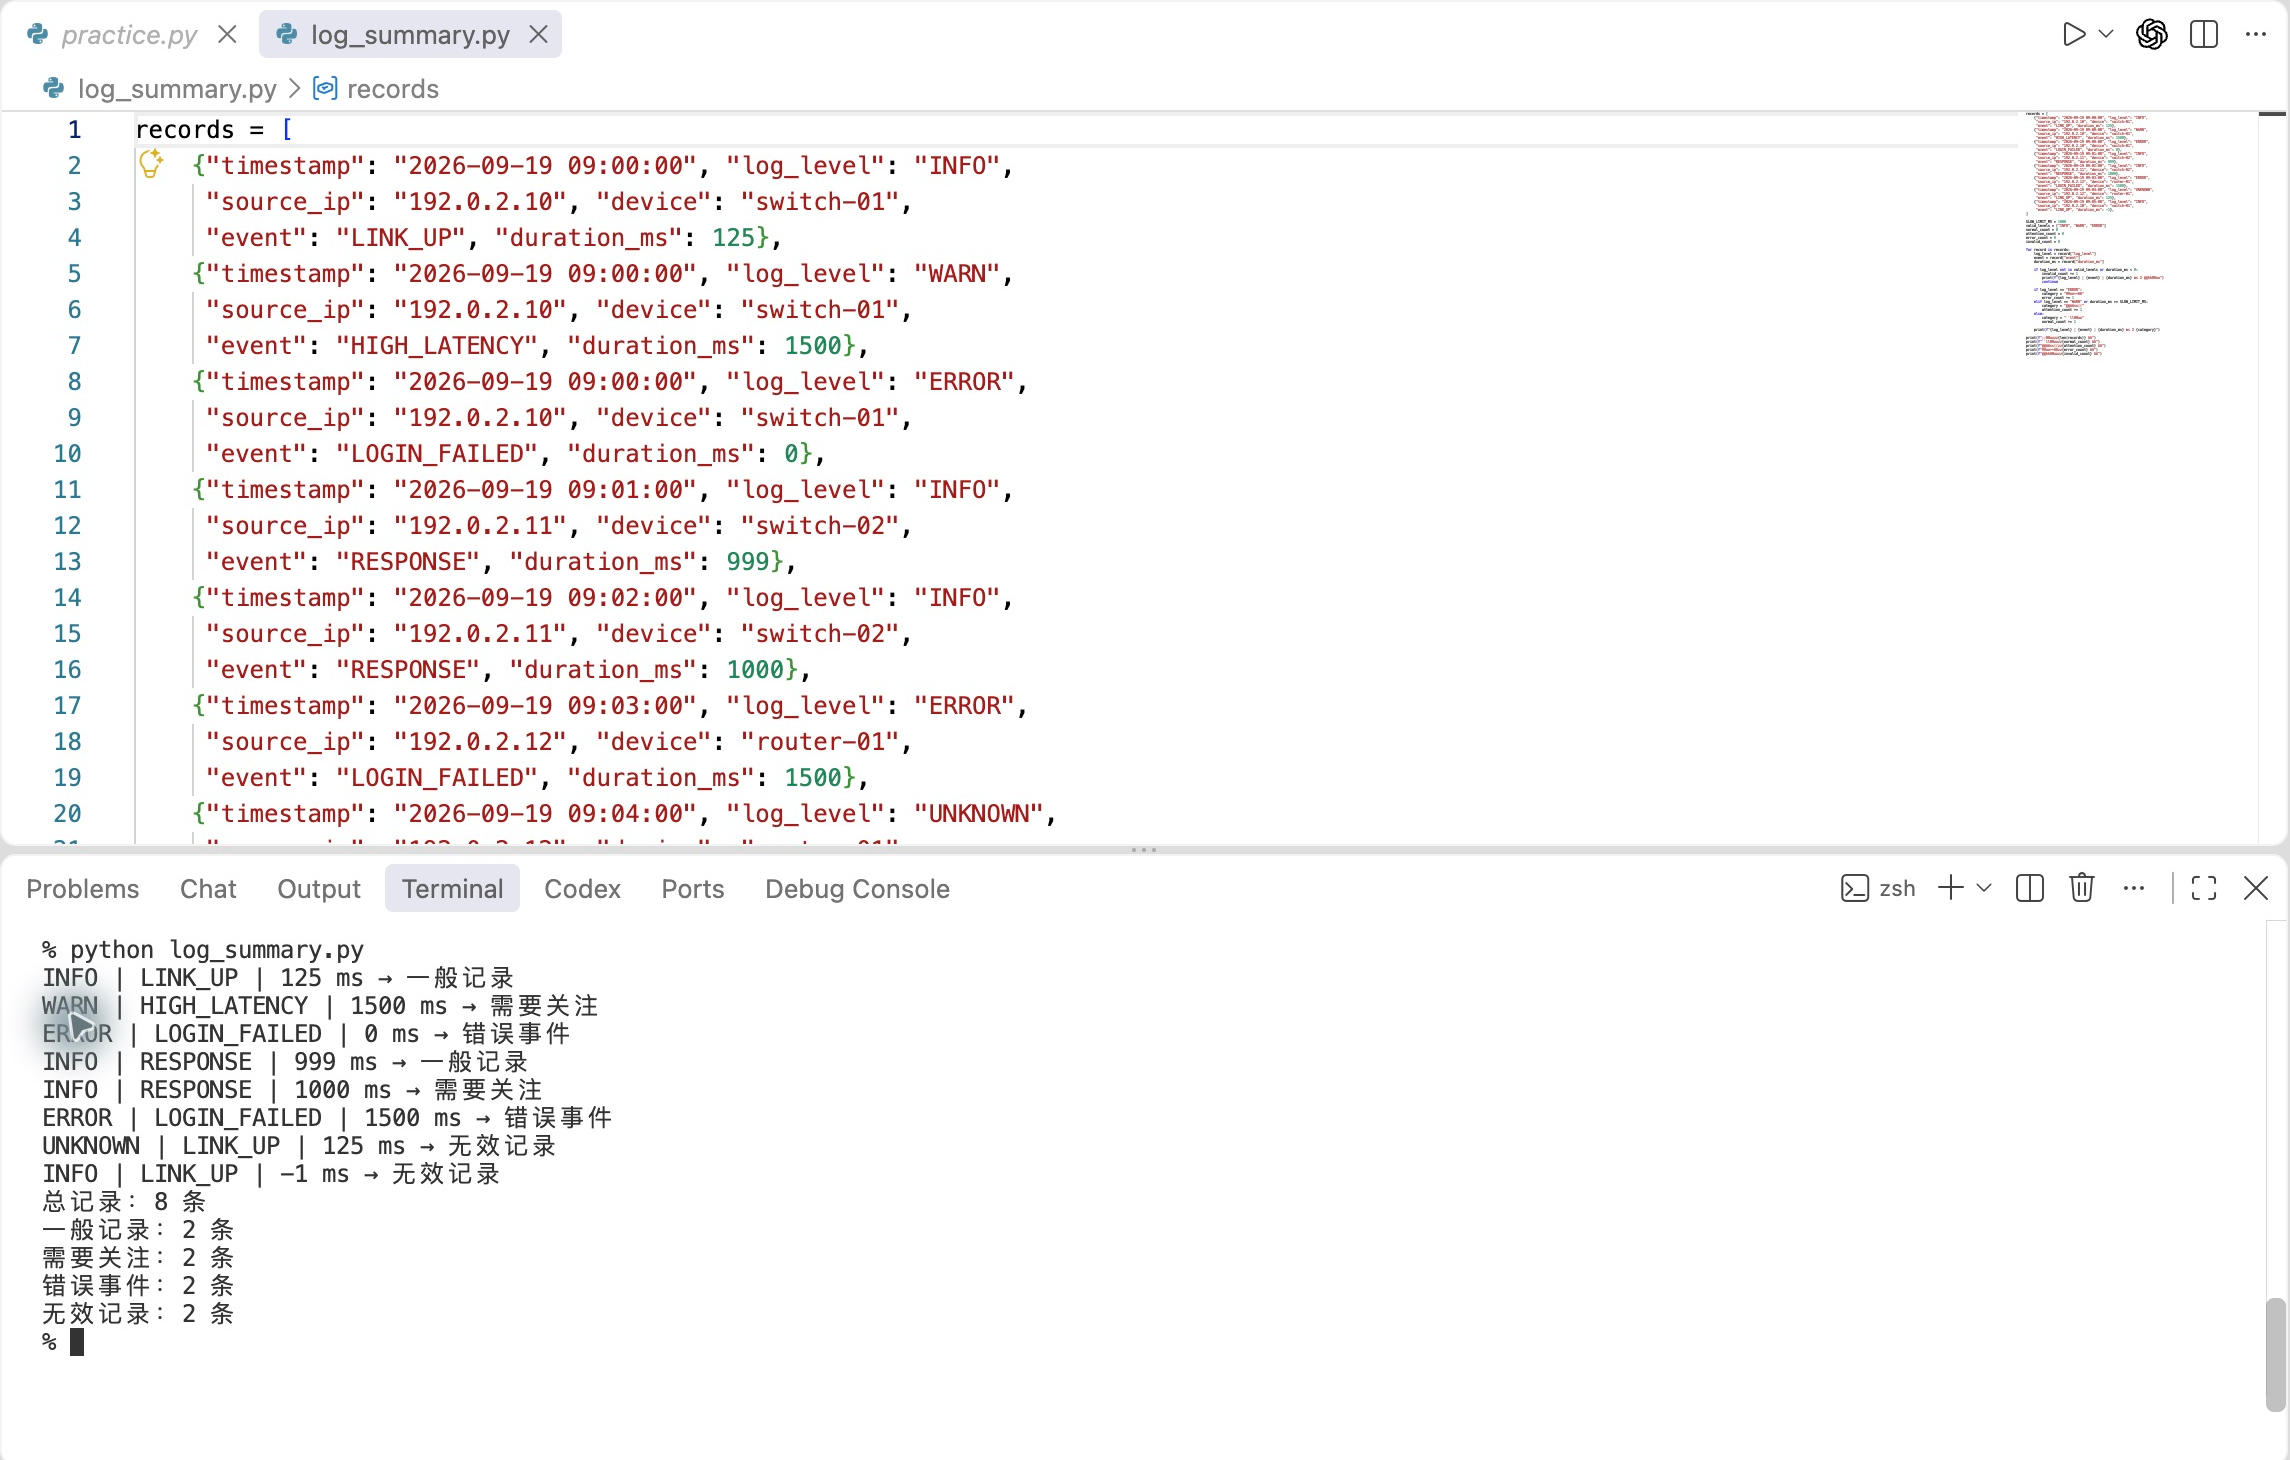
① 八条日志各归入一个类别;② 四类各为 2 条,总数为 8 条。
手机上可左右滑动;点击图片可以查看完整图再改变一项,预测数量怎样变
每次从原始八条数据出发,只做当前行的修改,运行后恢复。
左右滑动表格,可查看完整内容
| 改变什么 | 应观察到什么 | 它说明什么 |
|---|---|---|
| 把 D 的 999 改为 1000,再改为 1001 | 两次都变成一般 1、关注 3,其余各 2 | 相等与超过都满足 >= |
| 把 E 的 INFO、1000 改为 WARN、125 | 四类仍各为 2 | WARN 不依赖耗时达到阈值 |
| 把 F 的 ERROR 耗时改为 -1 | 无效 3、错误 1,其余各 2 | 有效性判断先于类别判断 |
| 把 records 暂时改为 [] | 总数与四个计数全为 0 | 不进入循环也能正常输出汇总 |
常见问题怎样定位
根据看到的现象,先改对应语句,再用相同数据重新运行。
左右滑动表格,可查看完整内容
| 现象 | 先看哪里 | 怎样改 |
|---|---|---|
| 提示缺少冒号或缩进不正确 | if、elif、else、for、while 所在行及下一行 | 补英文冒号,统一用四个空格表示一层缩进 |
| 字典取值时提示 KeyError | 方括号里的键是否与字典一致 | 使用已有的键,例如 duration_ms;注意拼写与大小写 |
| 读取列表时提示 IndexError | 下标是否超过元素位置 | 三个元素的下标是 0、1、2;遍历整组时使用 for |
| 结果一直像只有最后一条 | 初始化是否缩进到了 for 内部 | 将四个计数的初始赋值移到循环之前 |
| 同一条日志被计入两类 | 是否用了两个独立 if,或无效后忘记 continue | 分类连成 if/elif/else,无效计数后跳到下一轮 |
| 每条记录后都出现一次汇总 | 最后的 print 是否仍在循环内部 | 将最终汇总移出循环,与 for 左侧对齐 |
展示你的程序与解释
用完成的 log_summary.py 展示以下成果。
- 原始八条日志得到无效 2、错误 2、关注 2、一般 2,总数 8。
- 任选一条 ERROR 和一条无效记录,指出取值、条件、计数更新、输出及下一轮的路径。
- 完成上表四组改动,逐一解释数量变化,最后恢复原始八条数据。
- 用一句话分别说明列表、字典、分支和循环在这个程序中承担什么任务。
把本课进度保存下来
登录后可以保存浏览内容、有效学习时间、完成状态和答题参与记录。