第 05 课 · 函数设计、模块组织与标准库
把日志统计写成可复用的函数
一条日志怎样产生?怎样从一组记录中找出常见事件?沿着数据进入函数、带着结果返回的路线,把熟悉的日志程序组合成一个小工具。
完成后:亲自写出日志筛选函数,再组合字段统计、阈值判断与前 K 项排名
看清知识之间的关系
沿着学习路线,把知识点连成完整任务。点击知识点,可以跳到对应内容。
让一段处理可以重复使用
把输入交给函数,接住它的结果
从一项统计到一个工具
计数、分文件、排名,再组合运行
开始前准备好
- 先会什么
- 列表保存多条日志,字典保存字段,for 逐条处理。
- 用什么数据
- 沿用八条课堂模拟日志;先筛出六条有效记录。
- 怎样动手
- 短例逐个运行,最后在“学生练习”中写出筛选函数并接入主程序。
看图理解,动手运行
一条日志是怎样产生的
先认清要处理的东西,再决定程序需要做哪些事。
从左上角的事件出发,找到程序记录的位置,再看日志可以帮助我们回答什么问题。
手机上可左右滑动;点击图片可以查看完整图日志是程序留下的事件记录
连接建立、登录失败、响应变慢,都可能触发记录。系统按配置把相关信息写成日志;日志帮助我们还原经过,本身不会自动修好问题。
本课统一用时间、级别、来源 IP、设备、事件、耗时六项信息。不同设备的真实日志格式可能不同。
沿着图,说出一次事件的去向
以“设备登录失败”为例,用手指出图中的三个位置。
- 找到发生事件的设备或应用。
- 说出记录时间、设备和事件名称有什么用。
- 说明怎样统计一组日志中登录失败出现了多少次。
同一种步骤,会被反复使用
数级别、数 IP、数事件,都要“取出某个字段 → 累加次数 → 得到结果”。函数就是给一段处理起名字:以后传入数据,就能再次执行它。
下载第五课练习材料
解压后用 VS Code 打开 lesson-5-exercises 文件夹。在左侧右击“演示”,选择在集成终端中打开。每个短例独立运行。
- 演示:完整短例、模块示范和日志统计程序。
- 学生练习:先在 function_task.py 写筛选函数,再接入 main.py。
- 不需要额外安装程序库。
看图理解,动手运行
看懂一次函数调用
先完成一次调用,暂时只判断耗时是否达到 1000 毫秒。看清四个位置
def 建立名为 is_slow 的函数;定义中的 duration_ms 是接收数据的名称,也叫形参;调用时给出的 1000 是实际传入的值,也叫实参。缩进的语句是函数体,调用时才执行。
return 把结果交回调用处,并结束本次调用。result = is_slow(1000) 先调用,再把返回的 True 保存到 result。
先沿蓝色箭头进入函数,再沿青色箭头回到调用处。
手机上可左右滑动;点击图片可以查看完整图def is_slow(duration_ms):
return duration_ms >= 1000
print("准备调用函数")
result = is_slow(1000)
print(f"返回结果:{result}")
print("继续执行后面的代码")直接运行这个完整短例。函数定义写在前面,实际处理从下面的调用处开始。
名字与调用,差一个括号
只有发起调用,函数体才开始执行。
左右滑动表格,可查看完整内容
| 写法 | 表示什么 |
|---|---|
| is_slow | 函数本身;可以交给另一个名称,尚未判断耗时 |
| is_slow(1000) | 现在调用函数;本例得到 True |
找到进入与返回的位置
- 01
运行短例
这样做确认终端位于“演示”文件夹,再输入 python 01_first_call.py。若终端仍在解压后的根文件夹,先输入 cd 演示。
完成后应看到
先显示“准备调用函数”,然后是返回结果,最后继续执行后面的代码。
- 02
只改变传入的耗时
这样做把 is_slow(1000) 改成 is_slow(999),保存后再次运行。
完成后应看到
返回结果从 True 变成 False,前后两行提示仍然出现。
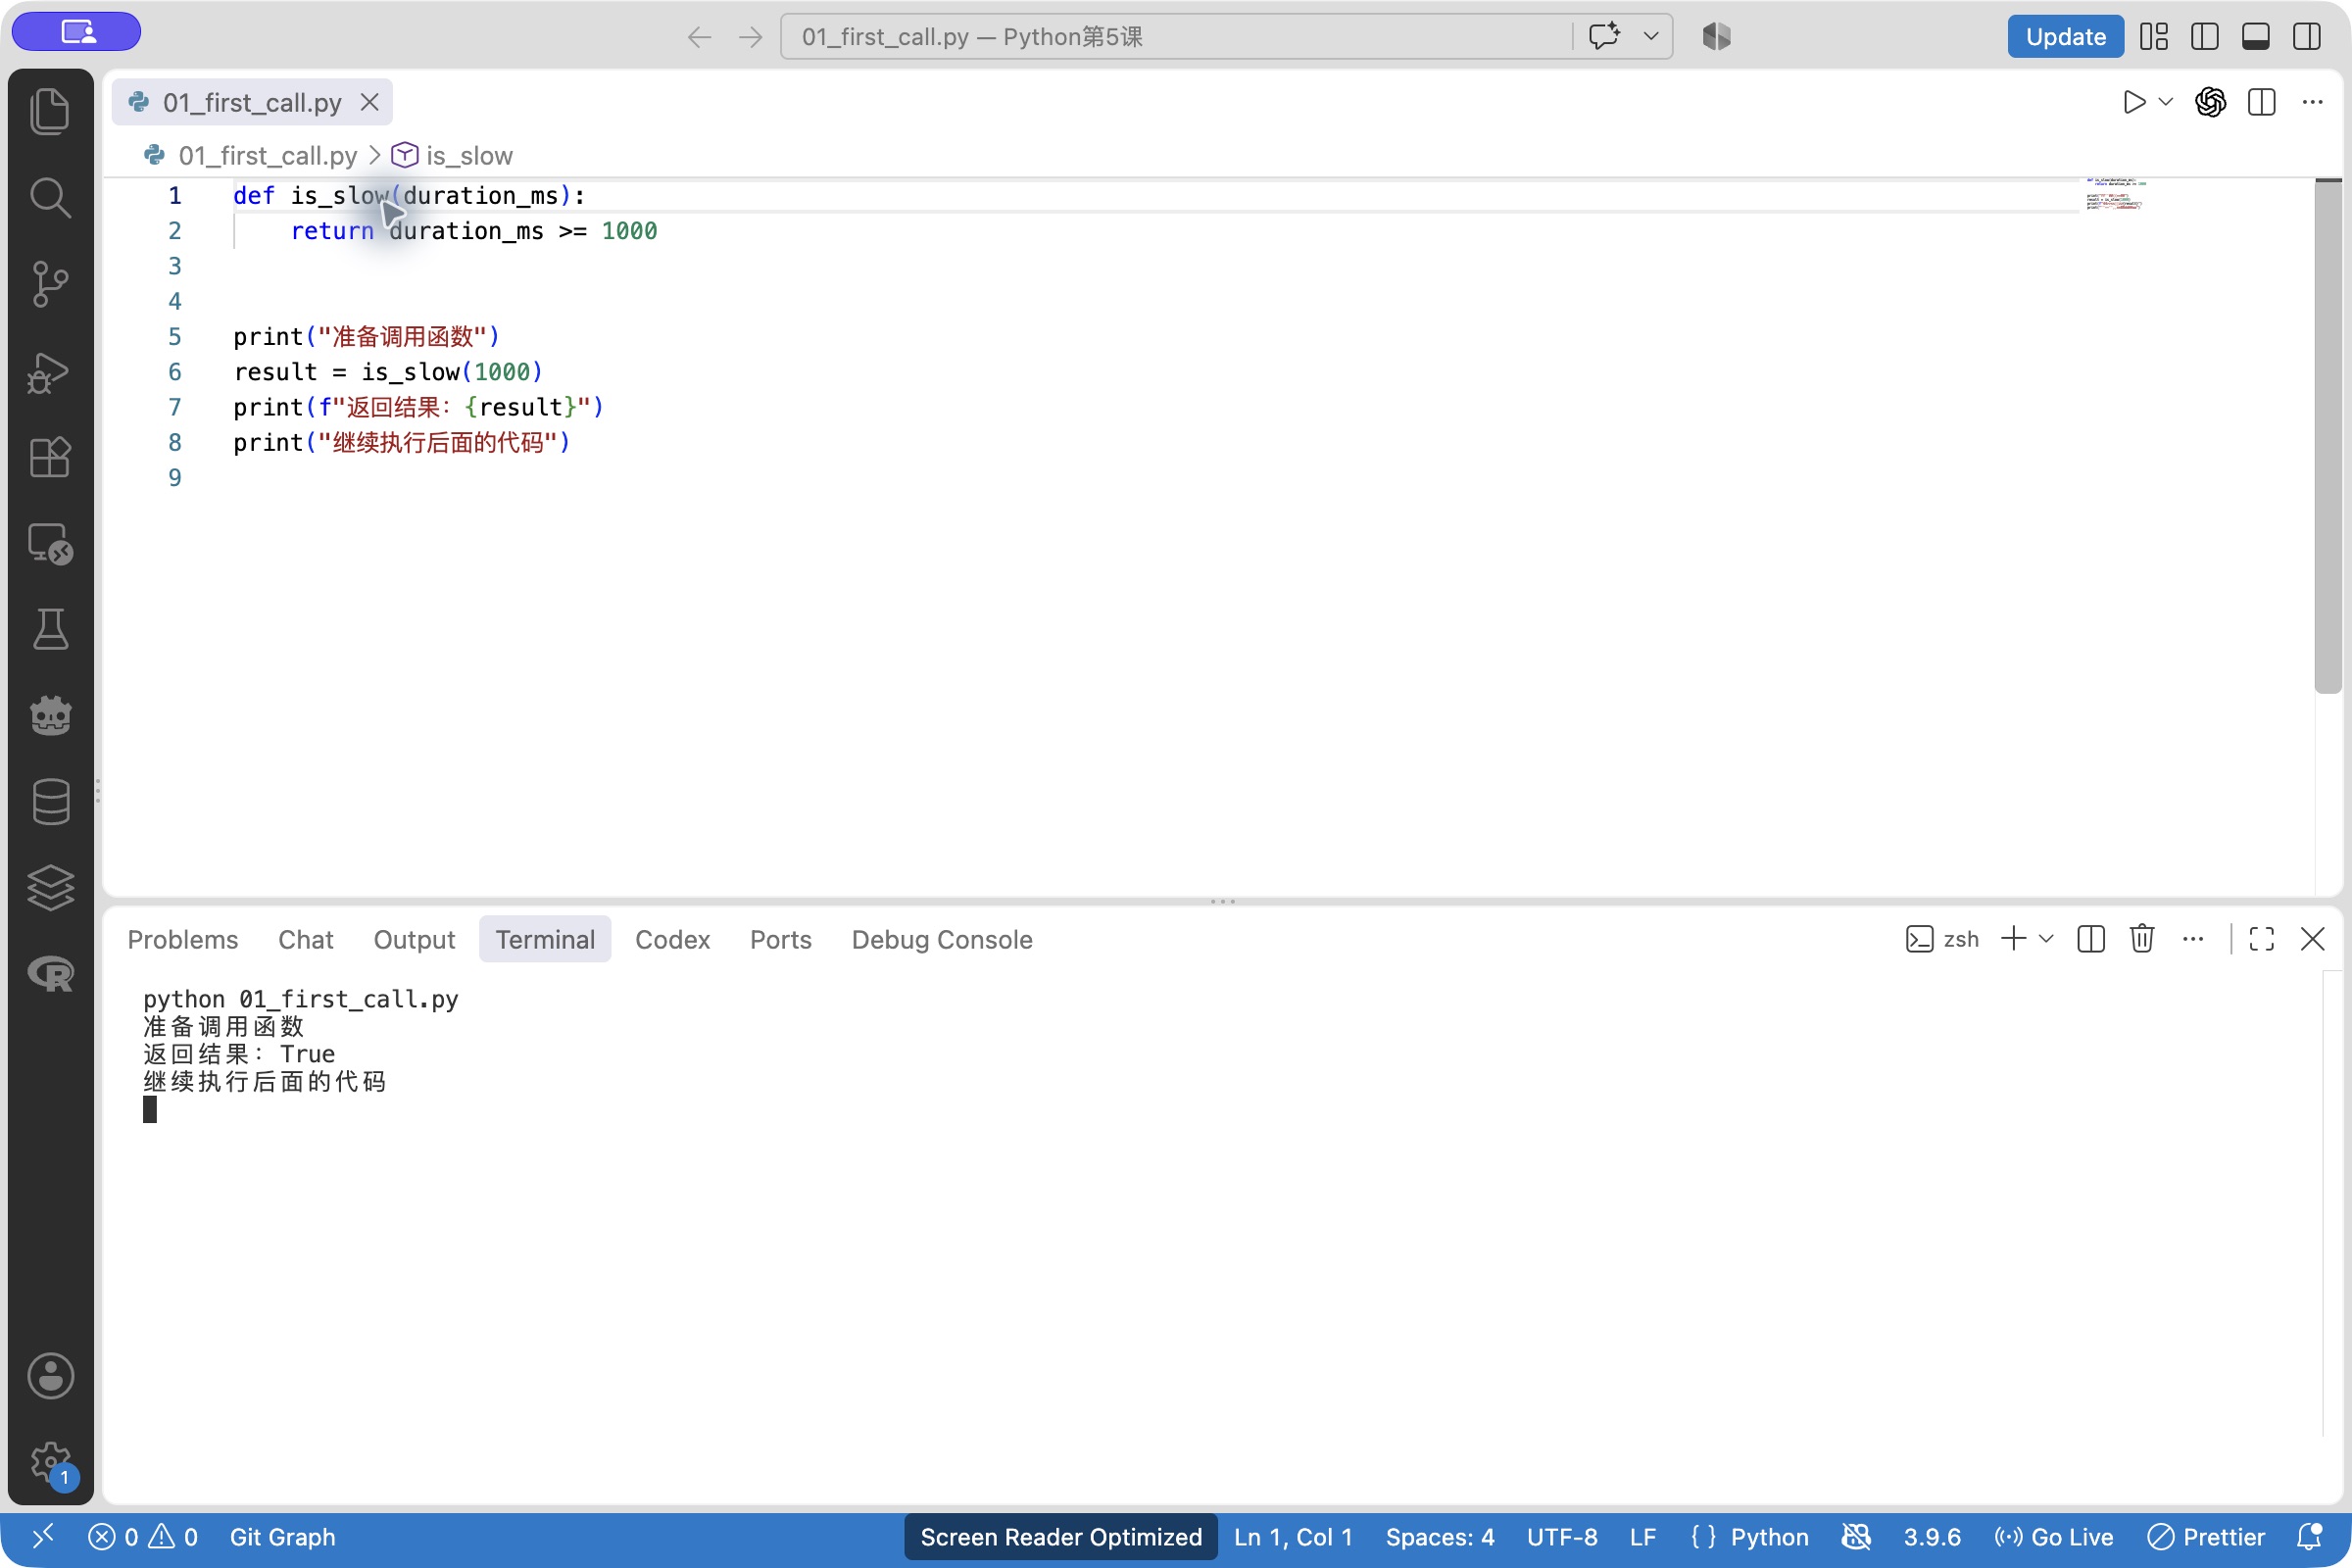
先看输出顺序:函数返回后,调用处下面的语句仍会继续执行。
手机上可左右滑动;点击图片可以查看完整图看图理解,动手运行
用参数改变输入
把阈值也作为输入,就能用同一段代码处理不同要求。
两种写法到达同样的参数位置;省略阈值时才使用默认的 1000。
手机上可左右滑动;点击图片可以查看完整图def is_slow(duration_ms, threshold_ms=1000):
return duration_ms >= threshold_ms
print(f"999 毫秒,默认阈值:{is_slow(999)}")
print(f"1000 毫秒,默认阈值:{is_slow(1000)}")
print(f"1001 毫秒,默认阈值:{is_slow(1001)}")
print(f"1001 毫秒,阈值 1500:{is_slow(1001, 1500)}")
# 定义中的 =1000 给出默认值;调用中的 threshold_ms=1500 指定这次的值。
position_result = is_slow(1001, 1500)
keyword_result = is_slow(1001, threshold_ms=1500)
named_result = is_slow(threshold_ms=1500, duration_ms=1001)
print(f"位置参数调用:{position_result}")
print(f"关键字参数调用:{keyword_result}")
print(f"按名称交换顺序:{named_result}")
print(f"位置与关键字结果相同:{position_result == keyword_result}")duration_ms 没有默认值,每次必须给出;threshold_ms 可以省略。定义处的 =1000 设置默认值,调用处的 threshold_ms=1500 按名称指定本次的值。
让调用与定义对应
普通定义中,没有默认值的参数放在前面。普通调用先写位置参数,再写关键字参数;关键字顺序可以交换,但名称要一致。
左右滑动表格,可查看完整内容
| 调用 | 怎样理解 |
|---|---|
| is_slow(1001, threshold_ms=1500) | 位置和名称一起使用;结果 False |
| is_slow() | 缺少必需的 duration_ms |
| is_slow(1000, duration_ms=999) | 同一参数给了两次值 |
| is_slow(1000, limit_ms=1500) | 定义中没有 limit_ms 这个参数名 |
跟着一条数据走进函数
从定义到输出,逐步观察数据去了哪里。切换两种耗时,比较达到阈值前后的结果。
- 定义
- 调用
- 比较
- 返回
- 接收
- 输出
第 1 行,当前讲解:def is_slow(duration_ms, threshold_ms=1000):第 2 行:return duration_ms >= threshold_ms第 3 行:第 4 行:result = is_slow(999)第 5 行:print(result)
亮色指向当前讲解的语句
先定义函数,函数体暂不执行
Python 读到 def 时建立函数。缩进的函数体要等到调用时才会执行。
调用处
函数外的代码result = is_slow(999)result尚未赋值还没执行到调用语句,result 尚未赋值。
is_slow 函数内部
已定义,尚未调用is_slow 已经定义。现在还没有数据进入函数。
终端输出
执行 print 后出现还没有输出
999 毫秒,第 1 步,共 6 步:先定义函数,函数体暂不执行。Python 读到 def 时建立函数。缩进的函数体要等到调用时才会执行。
先预测,再运行
运行 02_parameters.py,对照边界、位置传值与名称传值。
- 解释 999、1000、1001 在默认阈值下为何得到 False、True、True。
- 比较 is_slow(1001, 1500) 与 is_slow(1001, threshold_ms=1500),说明为什么都得到 False。
看图理解,动手运行
函数返回与数据变化
观察返回值,也观察调用前后的数据,理解函数内外怎样联系。
看两条不同的去向:return 回到调用处,print 显示在终端。
手机上可左右滑动;点击图片可以查看完整图def show_slow(duration_ms):
print(duration_ms >= 1000)
def is_slow(duration_ms):
return duration_ms >= 1000
printed_result = show_slow(1000)
returned_result = is_slow(1000)
print(f"只用 print,接到的结果:{printed_result}")
print(f"使用 return,接到的结果:{returned_result}")
# None 表示没有具体结果;True 是可以继续用于判断的结果。
if returned_result:
print("这条日志的耗时达到了阈值")None 表示没有具体结果。屏幕上出现 True,不代表接收变量里也是 True。
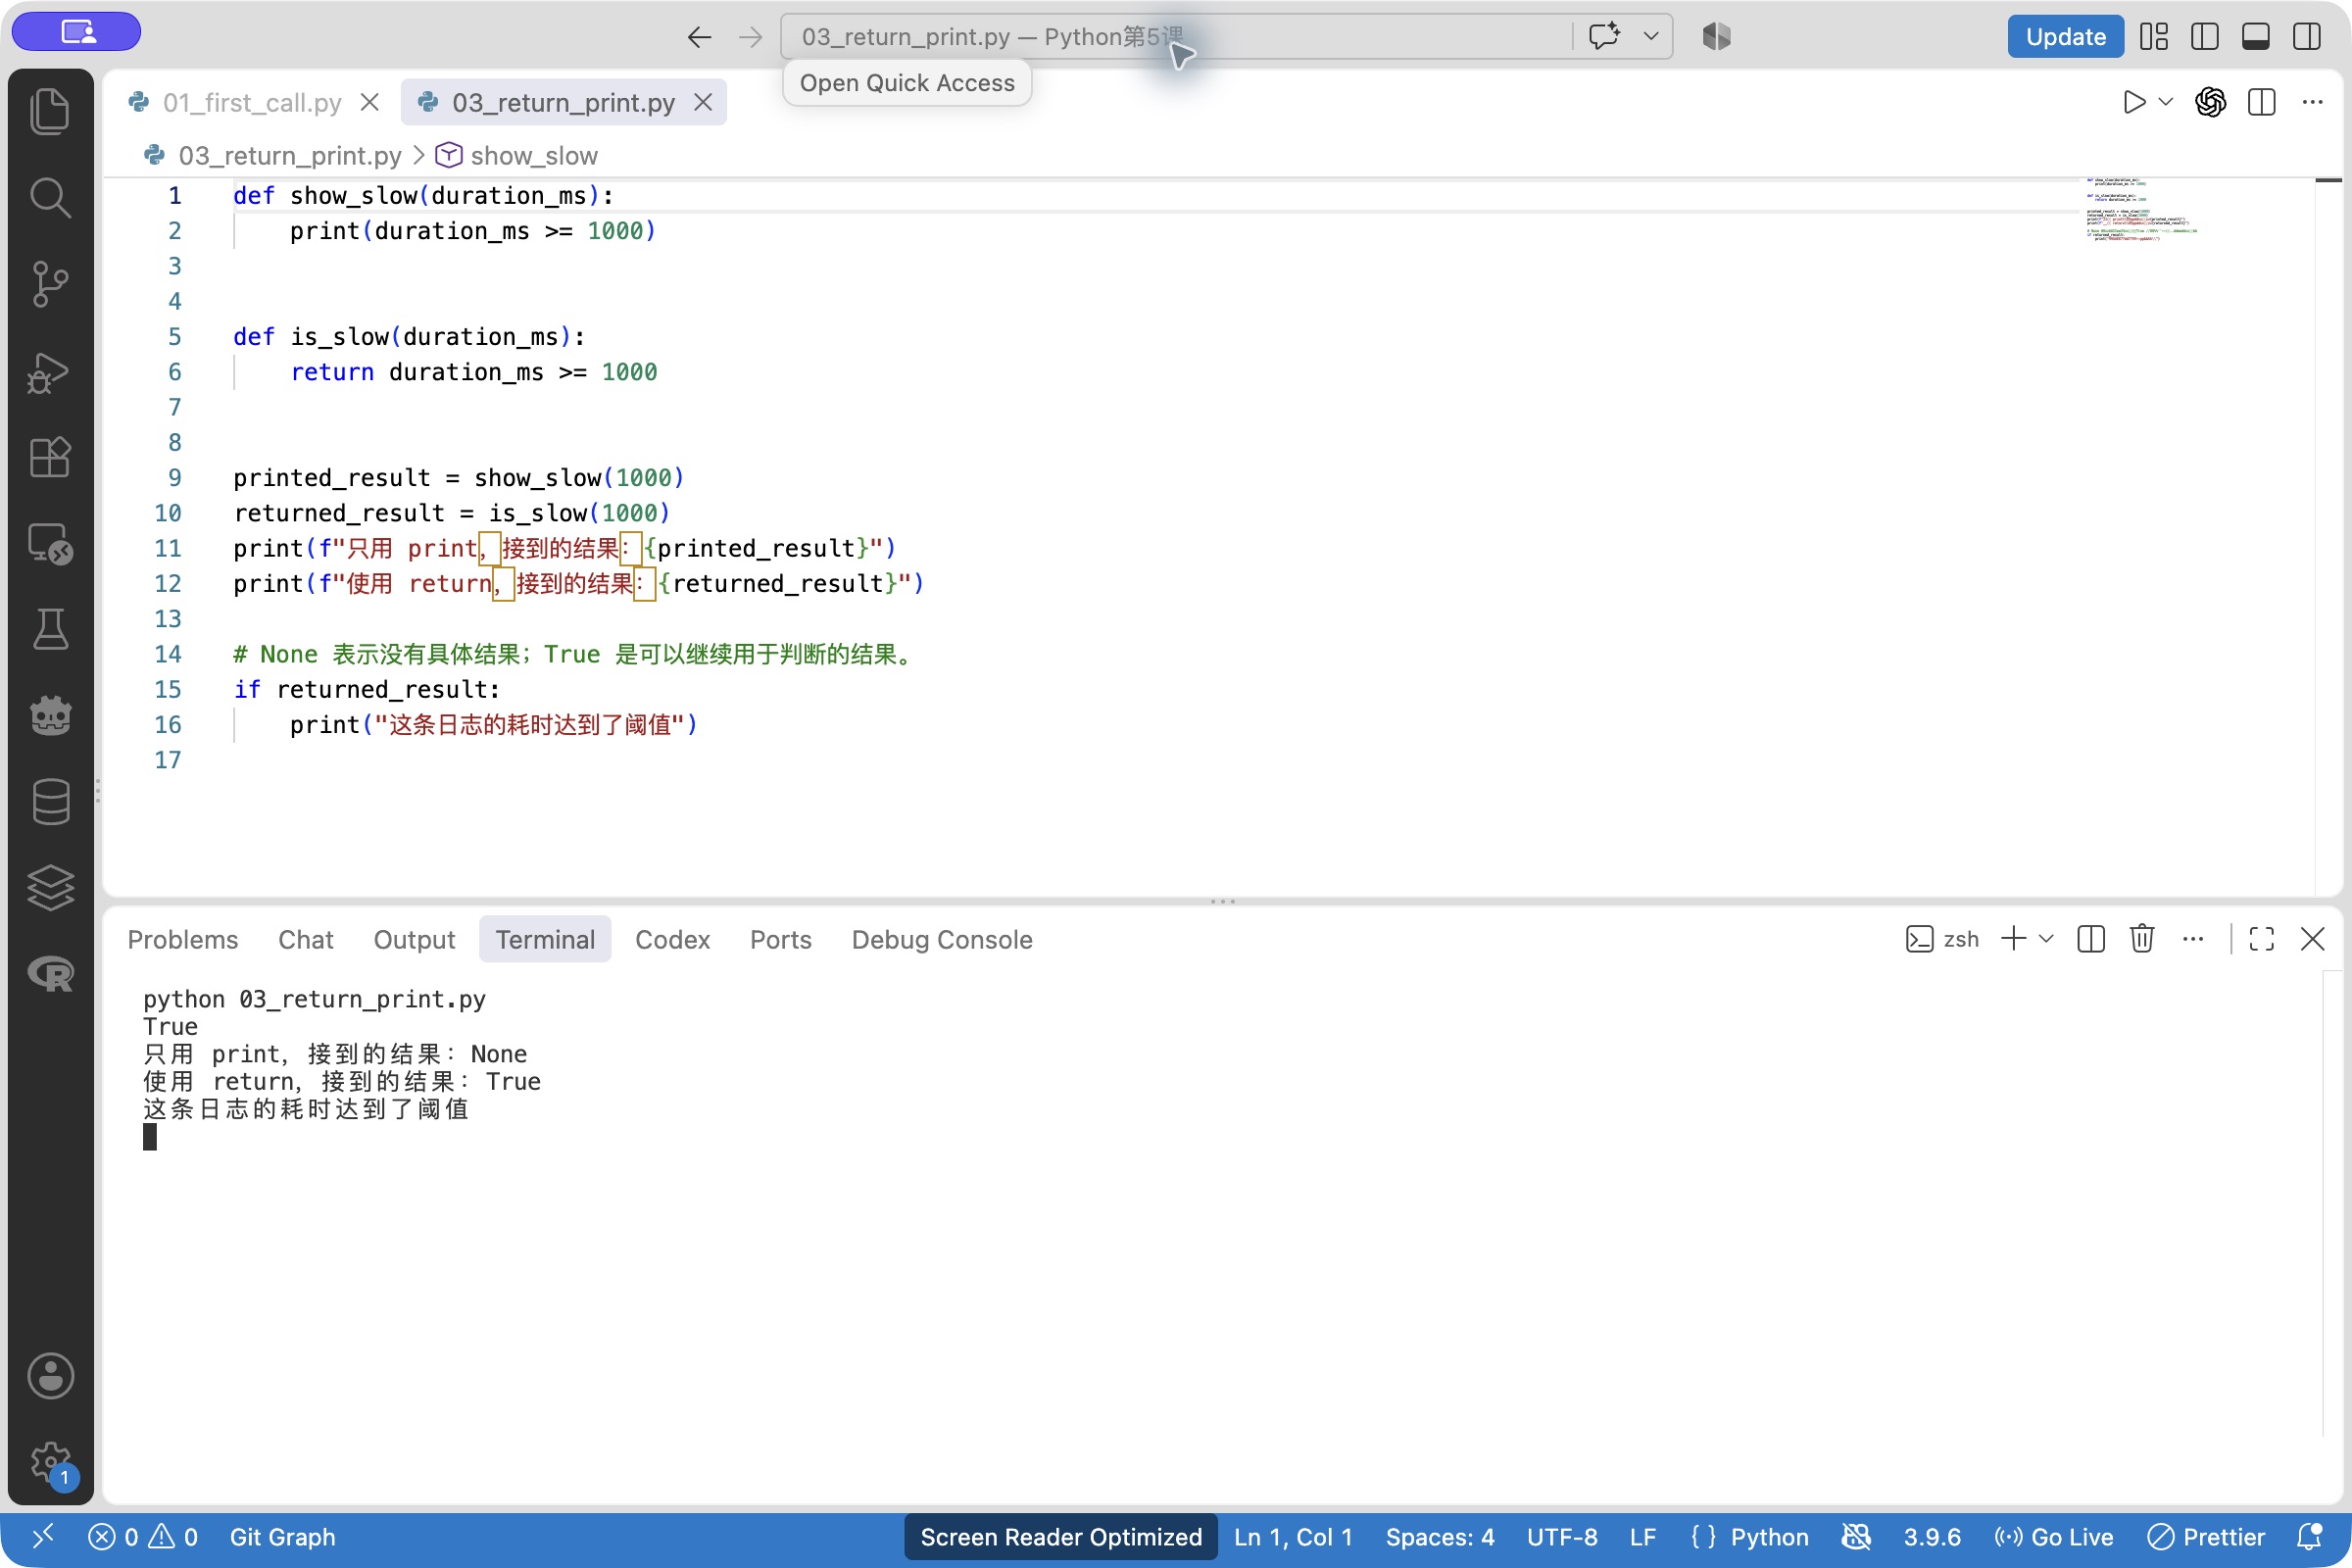
对照“接到的结果”两行,再找出最后的判断使用了哪个变量。
手机上可左右滑动;点击图片可以查看完整图def count_slow(durations):
slow_count = 0
for duration_ms in durations:
if duration_ms >= 1000:
slow_count += 1
return slow_count
slow_count = 99
first_result = count_slow([999, 1000, 1500])
second_result = count_slow([1000])
print(f"第一次调用:{first_result} 条")
print(f"第二次调用:{second_result} 条")
print(f"函数外的同名变量:{slow_count}")函数内部建立的 slow_count 是局部变量,只供这次调用使用。外部同名变量是另一个名字;通过返回值取得函数结果。
观察第二次调用
运行 04_local_scope.py,读出两次调用结果和外部 slow_count。
- 解释为什么第二次得到 1,而不是把第一次的 2 累加成 3。
- 指出代码怎样把每次调用的结果交回外部。
名字在函数内,字典可能由内外共用
参数不会自动复制传入的字典。修改 record[键] 是改变同一个字典;给局部 record 重新赋值,则是让这个名称指向别的字典。外部常量可以被读取,但本课把会改变的输入通过参数明确传入。
比较两组箭头:改内容和换指向是不同动作。这两个短例分别使用新建的临时记录。
手机上可左右滑动;点击图片可以查看完整图def change_record(record):
record["duration_ms"] = 1500
def replace_local_record(record):
record = {"log_level": "INFO", "duration_ms": 1500}
print(f"函数内部的新字典:{record['duration_ms']} 毫秒")
# 两次调用分别使用新建的字典,不改变整组课堂日志。
first_record = {"log_level": "INFO", "duration_ms": 125}
change_record(first_record)
print(f"修改字段后,外部 first_record:{first_record['duration_ms']} 毫秒")
second_record = {"log_level": "INFO", "duration_ms": 125}
replace_local_record(second_record)
print(f"局部重新赋值后,外部 second_record:{second_record['duration_ms']} 毫秒")先预测外部字典最后的耗时,再运行。这里使用临时记录,不改动整组课堂日志。
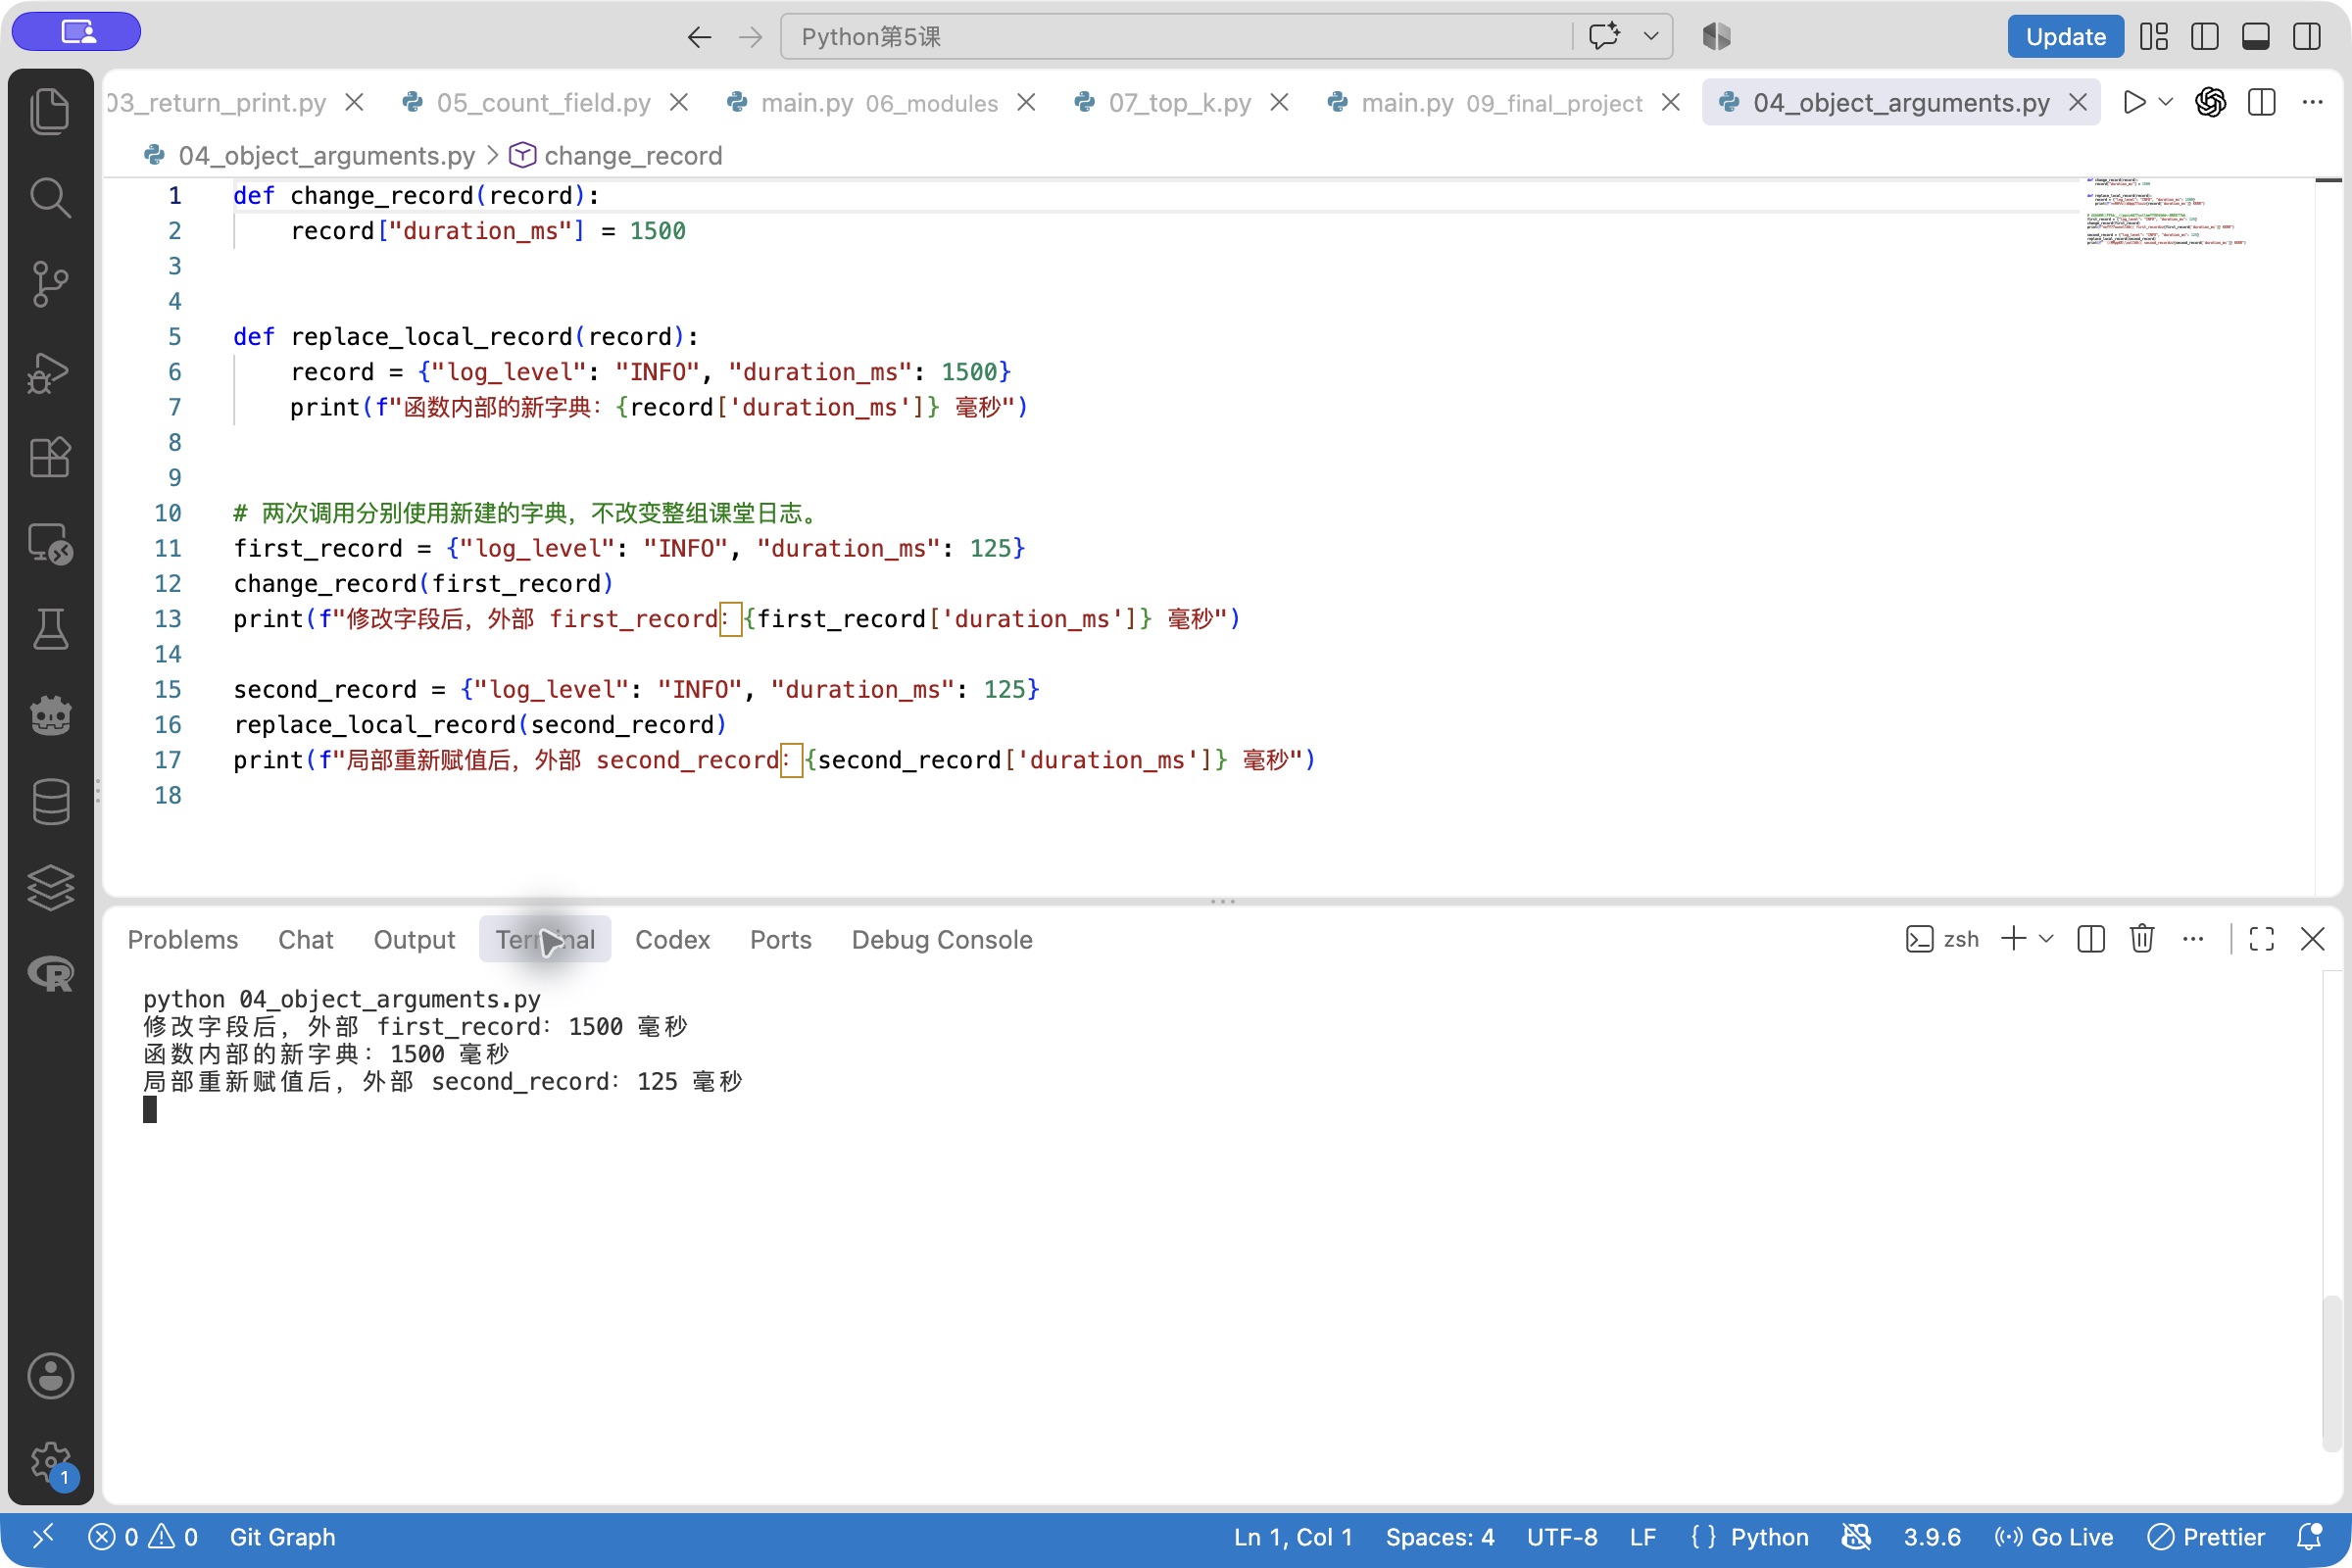
不要只看函数内部的新字典;还要看外部名称最终读到什么。
手机上可左右滑动;点击图片可以查看完整图# 有意对比两种写法:第一种默认列表会被后面的调用继续使用。
def collect_shared(record, collected=[]):
collected.append(record)
return collected
def collect_fresh(record):
collected = []
collected.append(record)
return collected
first_record = {"log_level": "INFO", "duration_ms": 125}
second_record = {"log_level": "WARN", "duration_ms": 1500}
print(f"默认列表,第一次:{len(collect_shared(first_record))} 条")
print(f"默认列表,第二次:{len(collect_shared(second_record))} 条")
print(f"函数内新建列表,第一次:{len(collect_fresh(first_record))} 条")
print(f"函数内新建列表,第二次:{len(collect_fresh(second_record))} 条")默认值在执行函数定义时建立。第一种写法用来观察共享列表;本课每次独立处理数据时,采用第二种在函数体内新建列表的方式。
把两次调用放在一起看
运行 04_mutable_defaults.py,比较两组数量。
- 解释默认列表为何依次得到 1、2,函数内新建列表为何得到 1、1。
- 指出列表建立在哪一行;若需要两次独立统计,不把同一份可变列表留作默认输入。
看图理解,动手运行
组织统计与返回结果
先完成整组统计,再比较提前返回与多项结果的不同用途。
记录没有换,改变的是传入的字段名。两种统计的次数相加都等于六条有效记录。
手机上可左右滑动;点击图片可以查看完整图def count_by_field(valid_records, field_name):
counts = {}
for record in valid_records:
value = record[field_name]
if value not in counts:
counts[value] = 0
counts[value] += 1
return counts
records = [
{"log_level": "INFO", "source_ip": "192.0.2.10"},
{"log_level": "WARN", "source_ip": "192.0.2.10"},
{"log_level": "ERROR", "source_ip": "192.0.2.10"},
{"log_level": "INFO", "source_ip": "192.0.2.11"},
{"log_level": "INFO", "source_ip": "192.0.2.11"},
{"log_level": "ERROR", "source_ip": "192.0.2.12"},
]
level_counts = count_by_field(records, "log_level")
ip_counts = count_by_field(records, "source_ip")
print(f"级别统计:{level_counts}")
print(f"来源 IP 统计:{ip_counts}")这里先保留当前要看的两个字段。counts = {} 每次调用建立一个空字典;新键先从 0 开始,再加 1。
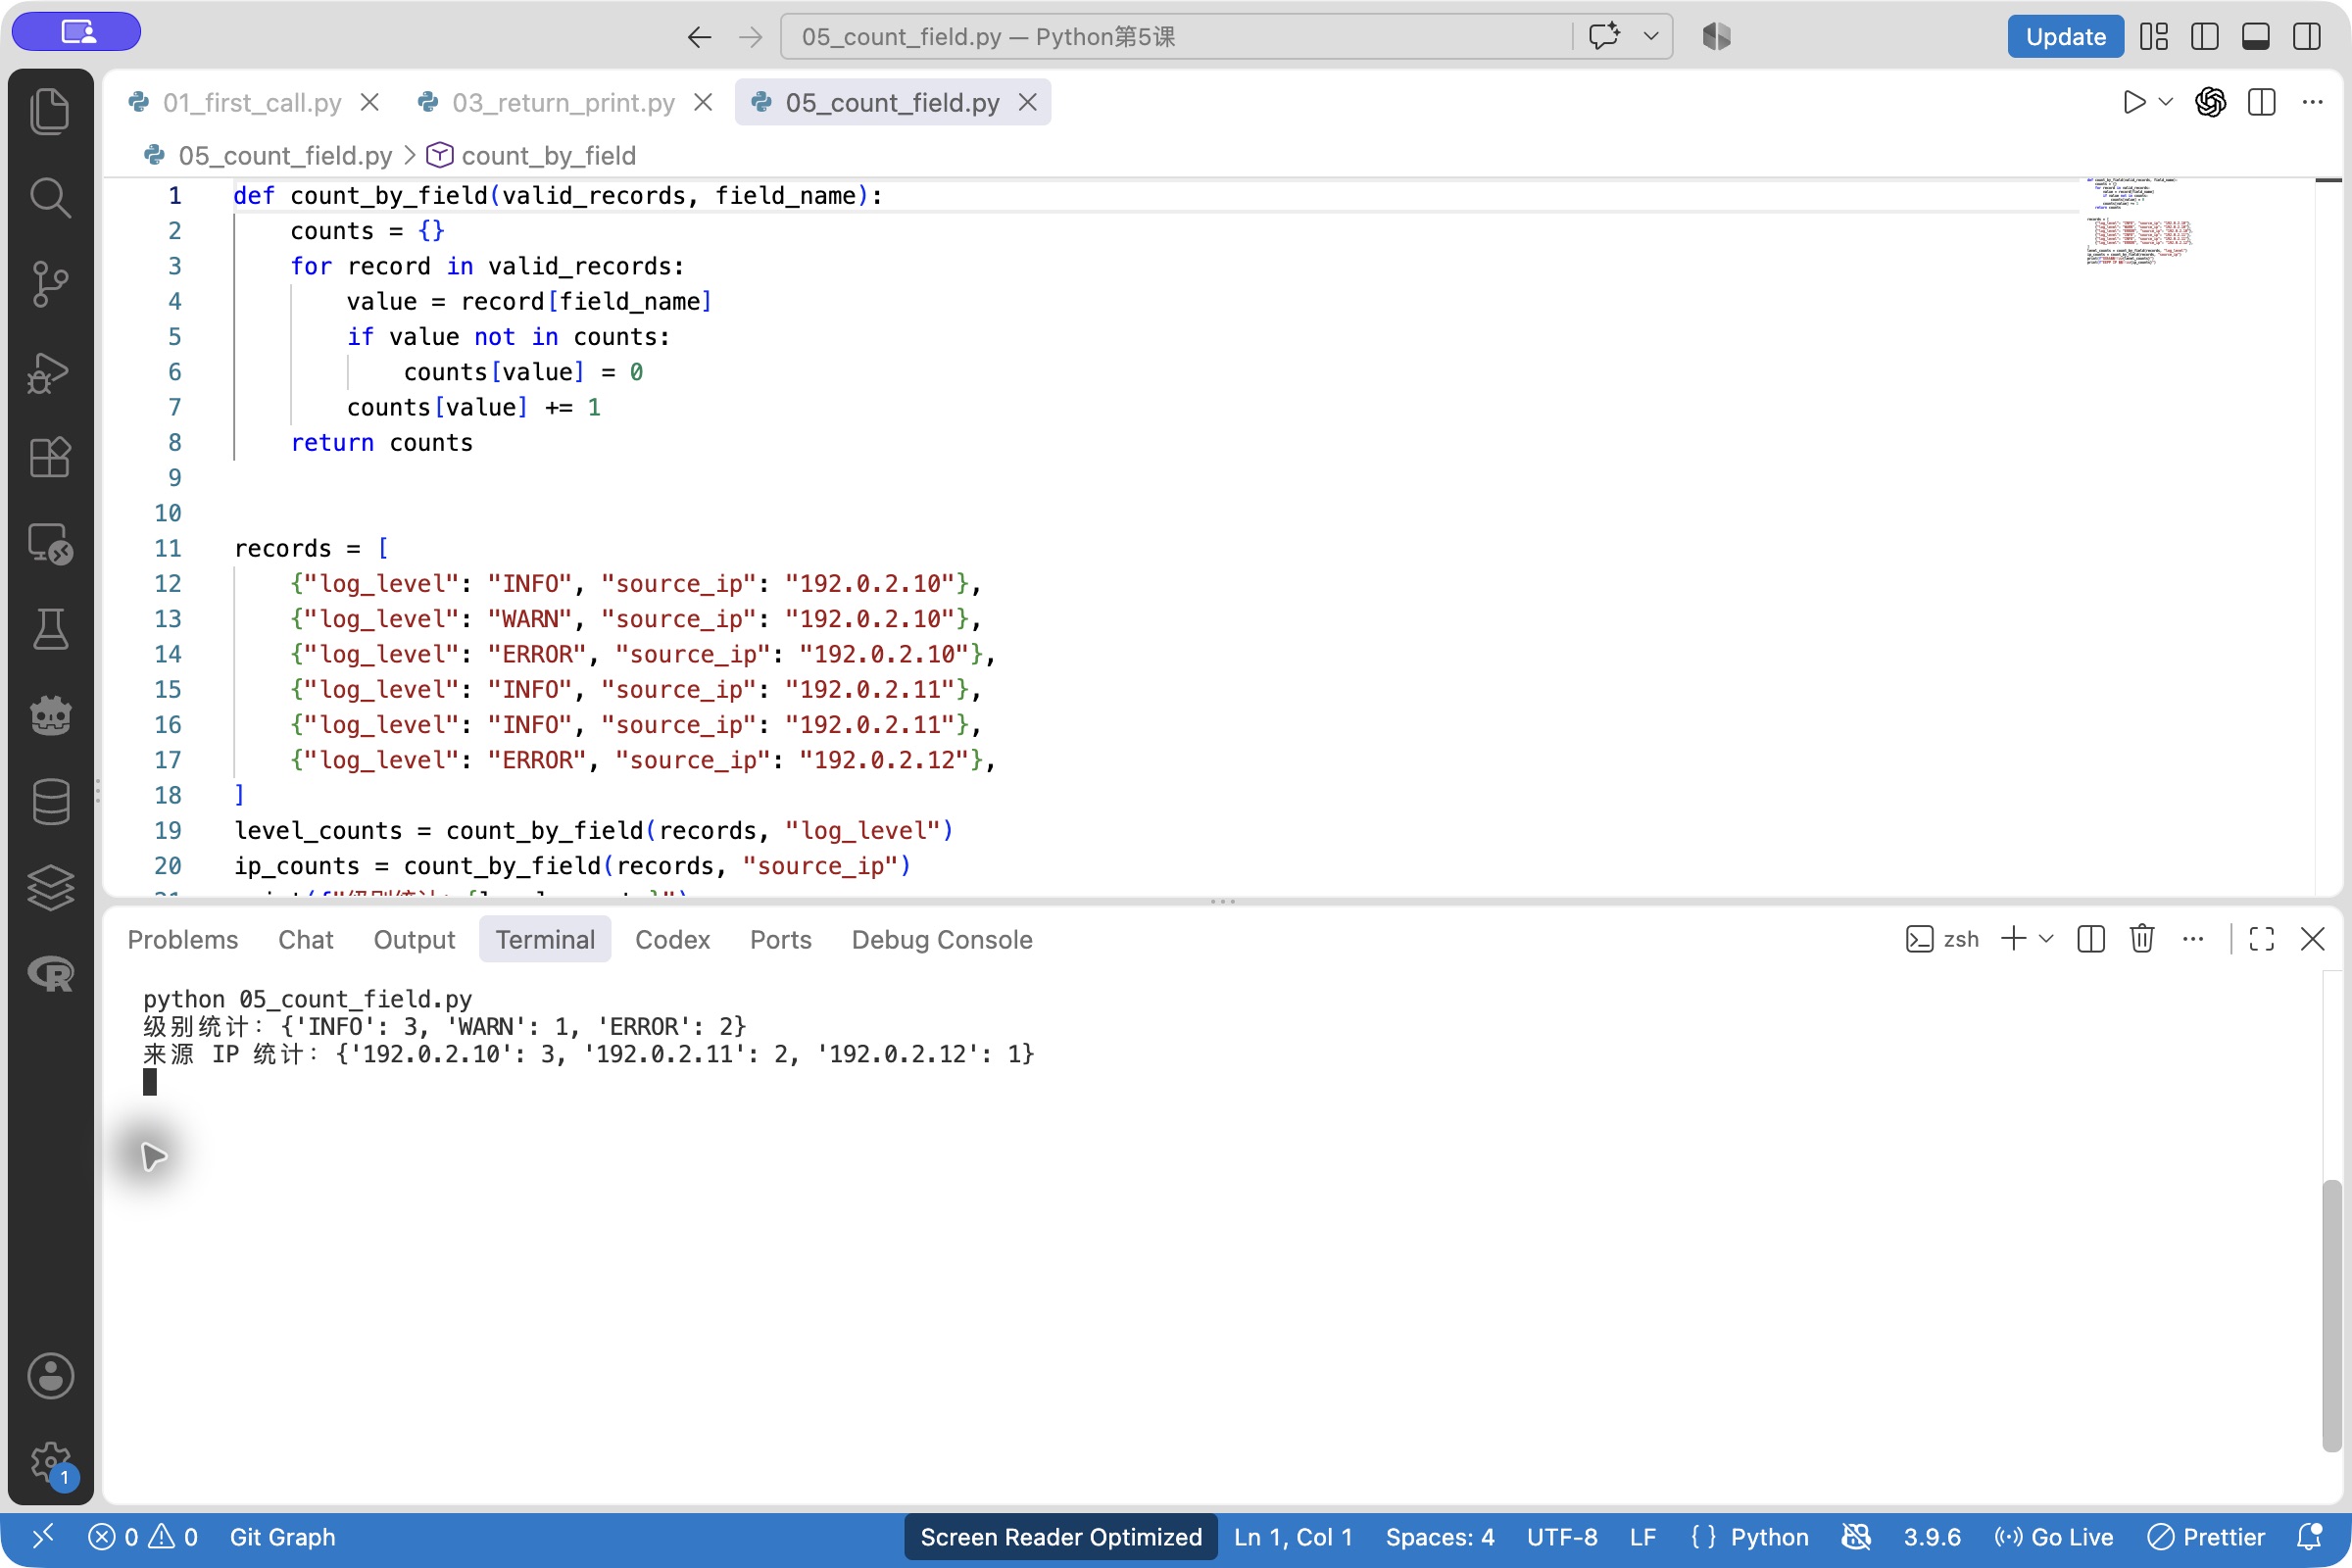
先核对级别的 3、1、2,再核对三个 IP 的 3、2、1。
手机上可左右滑动;点击图片可以查看完整图让计数完成后再返回
先运行 05_count_field.py,再运行 08_return_position.py 比较 return 的位置。
- 指出 counts 的创建、键的首次出现、计数更新和最终返回分别在哪。
- 观察提前返回为什么漏掉后面的记录,再用循环结束后的返回得到完整结果。
提前返回也可以是正确的处理
统计整组记录要等循环完成;判断一条无效输入则可以立即返回。关键是返回位置符合任务,而不是所有 return 都必须写在最后。每条执行路径都应返回约定的结果;遗漏的路径会得到 None。
遇到 return 就结束本次调用;调用处后面的程序仍然继续。
手机上可左右滑动;点击图片可以查看完整图def is_slow_or_none(duration_ms, threshold_ms=1000):
if duration_ms < 0:
return None
return duration_ms >= threshold_ms
# None 表示本例输入无效;False 表示输入有效,但没有达到阈值。
print(f"-1 毫秒:{is_slow_or_none(-1)}")
print(f"999 毫秒:{is_slow_or_none(999)}")
print(f"1000 毫秒:{is_slow_or_none(1000)}")
print("三次调用结束,继续执行后面的代码")本例约定 None 表示无效输入,False 表示有效但没达到阈值,True 表示有效且达到阈值。
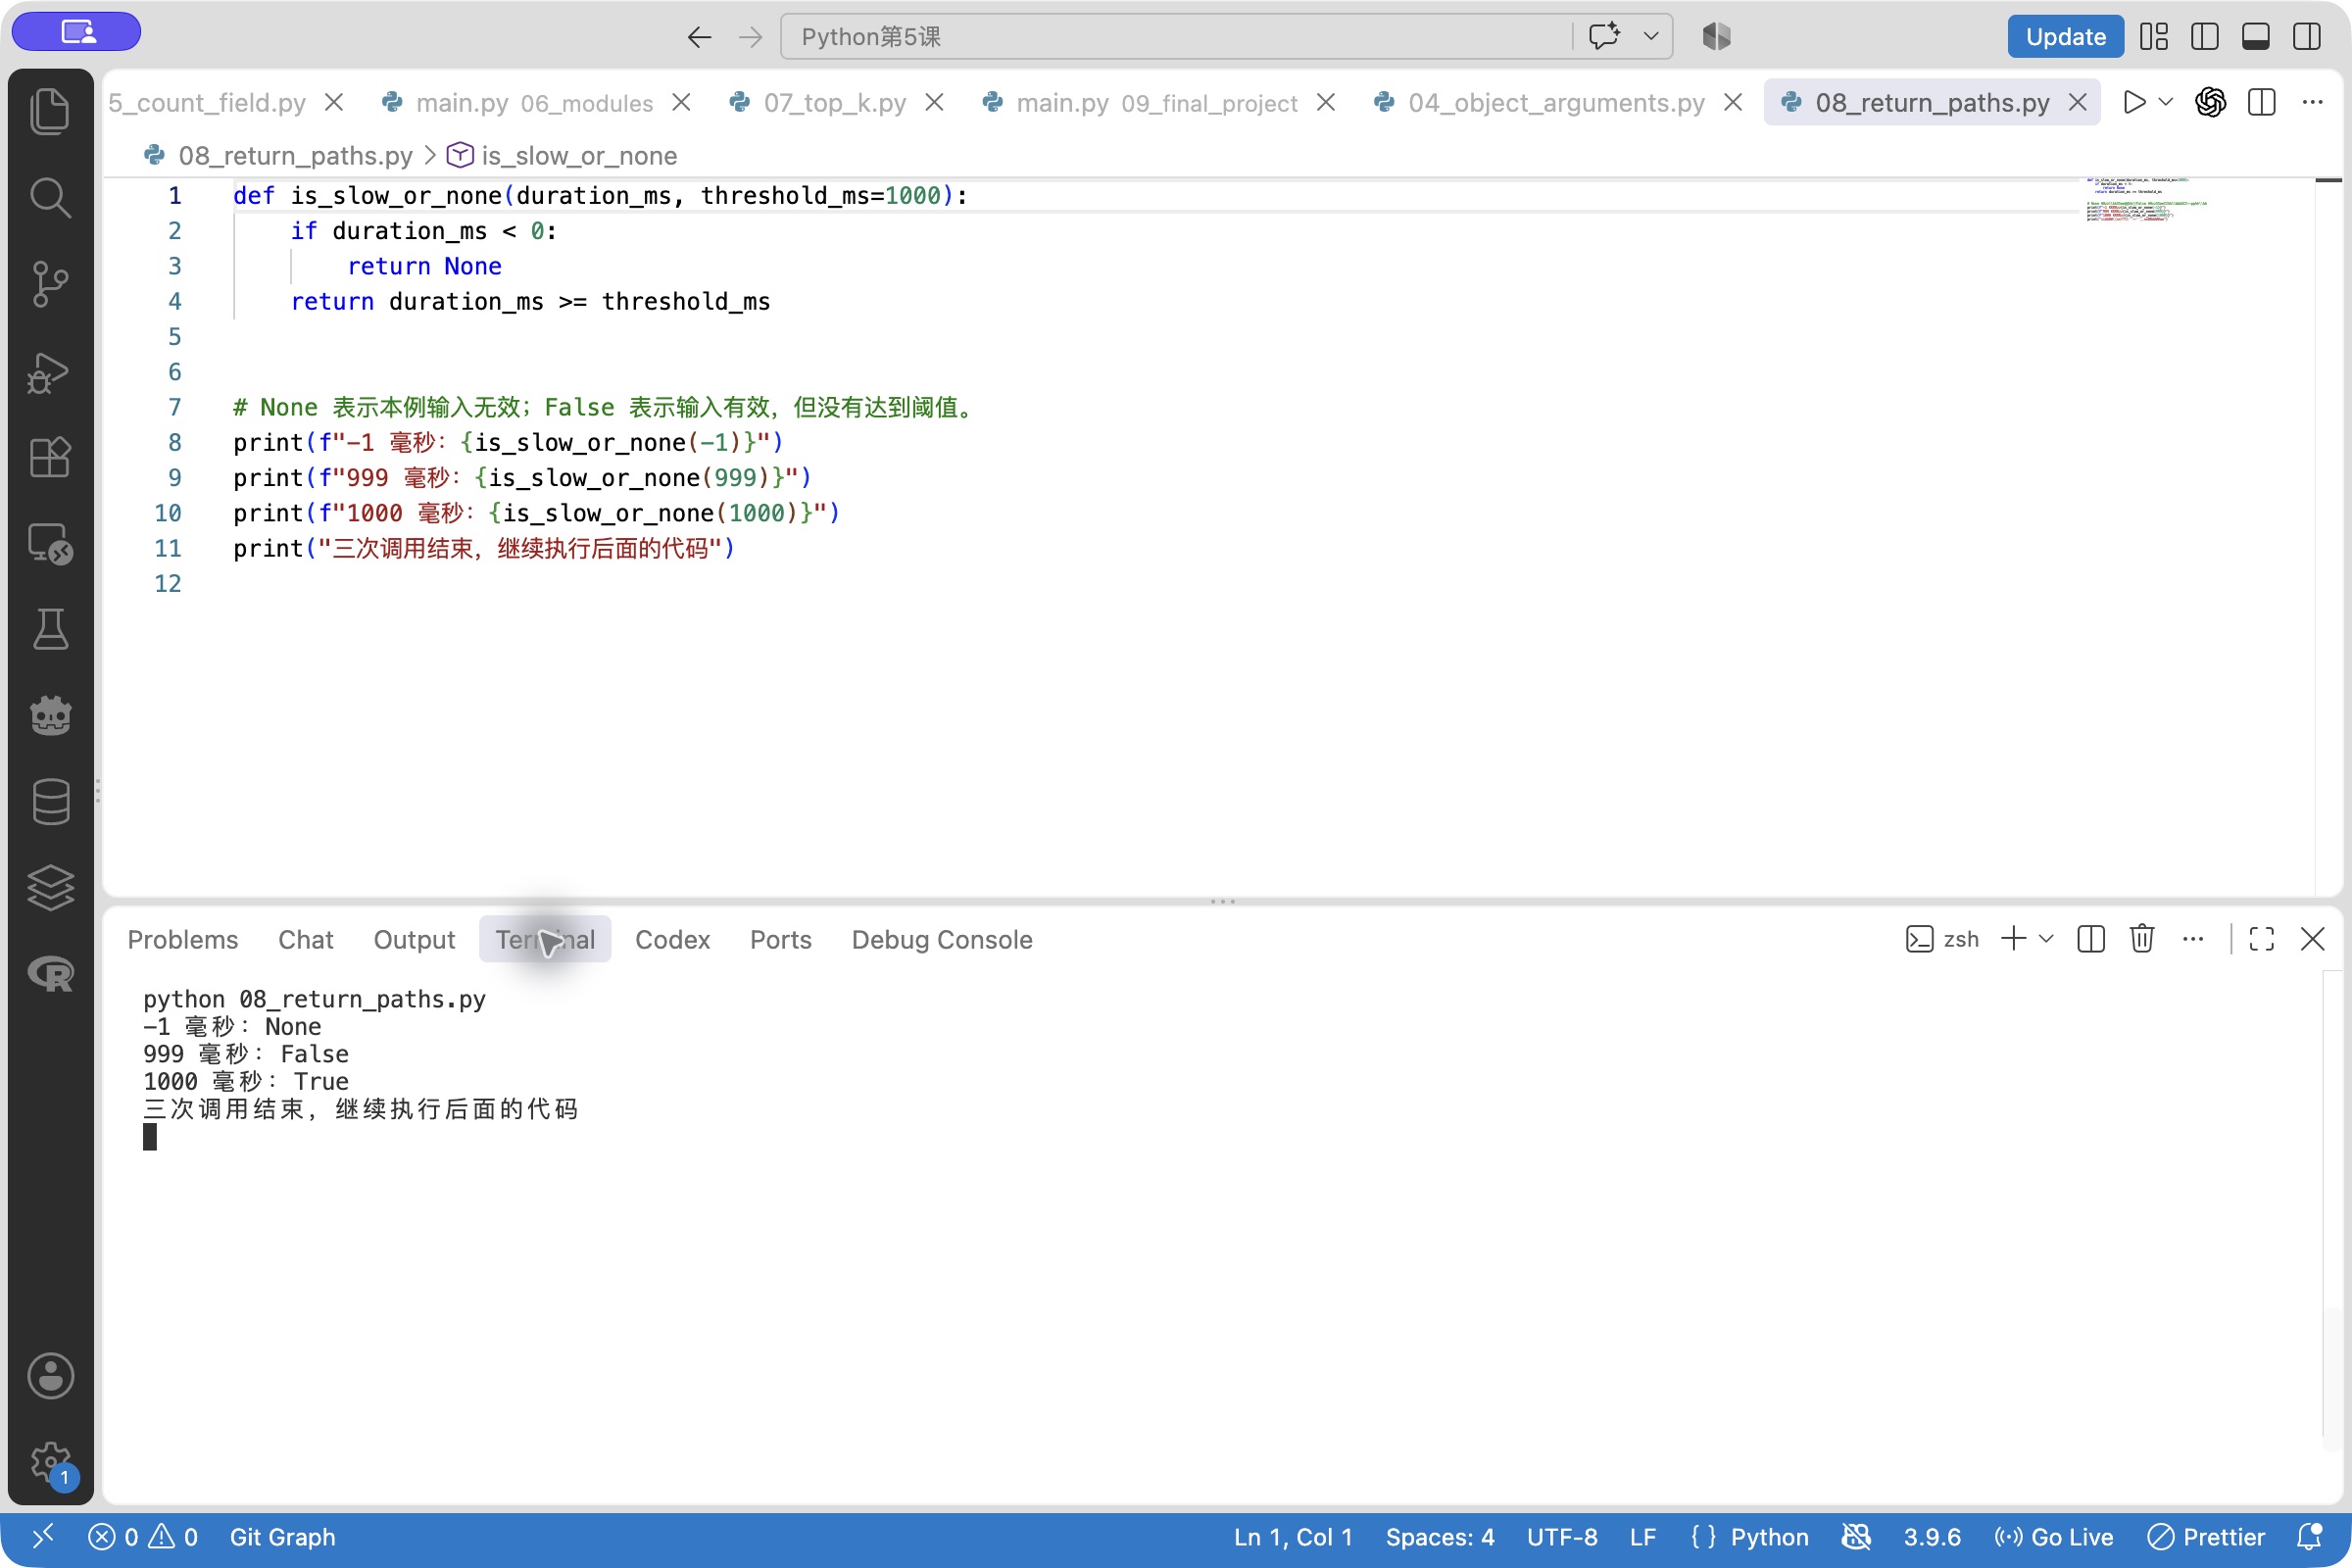
三个输入各走自己的返回路径;None 与 False 表达不同情况。
手机上可左右滑动;点击图片可以查看完整图def split_records(records):
valid_records = []
invalid_records = []
for record in records:
level_ok = record["log_level"] in ["INFO", "WARN", "ERROR"]
if level_ok and record["duration_ms"] >= 0:
valid_records.append(record)
else:
invalid_records.append(record)
return valid_records, invalid_records
records = [
{"log_level": "INFO", "duration_ms": 125},
{"log_level": "UNKNOWN", "duration_ms": 125},
{"log_level": "WARN", "duration_ms": 1500},
{"log_level": "INFO", "duration_ms": -1},
]
# 一次返回的是一个元组;左边两个名称按顺序接住元组里的两个列表。
valid_records, invalid_records = split_records(records)
print(f"有效记录:{len(valid_records)} 条")
print(f"无效记录:{len(invalid_records)} 条")
print(f"原列表仍有:{len(records)} 条")
# 新建的是分类列表,列表里的字典仍是原来的字典,没有复制字典内容。逗号把两个列表装成一个元组返回,左侧两个名称按顺序分别接收,这叫解包。也可以用字典给多项结果起名字。
说清返回了什么
运行 08_split_results.py,再找到 return 与调用处的赋值。
- 确认有效 2 条、无效 2 条,原列表仍有 4 条。
- 说明新建的是两个分类列表,列表里的字典仍是原来的字典;新列表不等于复制每条记录。
看图理解,动手运行
连接文件与函数
函数已经能够运行,现在把数据、处理和组织调用分开保存。打开 06_modules 文件夹
主程序依赖下面三个核心文件,均已完整提供。其余文件用于独立观察导入或阅读说明,无需依次运行它们才能启动 main.py。
左右滑动表格,可查看完整内容
| 文件 | 负责什么 |
|---|---|
| records.py | 保存八条课堂日志 |
| log_tools.py | 定义有效性判断、耗时判断和计数函数 |
| main.py | 导入数据与函数,组织调用并显示结果 |
一个 .py 文件也可以作为模块
模块就是可以被导入、重复使用的 Python 文件。from log_tools import count_by_field 把这个函数名带到当前文件;它不会替你调用函数。
is_valid 沿用第四课的规则:级别属于 INFO、WARN、ERROR 且耗时非负时返回 True。主程序据此筛出六条有效记录;append 把一条记录追加到列表末尾。
别名属于当前文件,不会把 log_tools.py 改名;三种方式调用的是同一个函数。
手机上可左右滑动;点击图片可以查看完整图import log_tools
from log_tools import is_slow
import log_tools as tools
print(f"模块名.函数名:{log_tools.is_slow(1000)}")
print(f"直接使用函数名:{is_slow(1000)}")
print(f"别名.函数名:{tools.is_slow(1000)}")在“演示”目录运行 python 06_modules/import_forms.py。先指认每个名称从哪里导入,再读对应调用。
from log_tools import is_slow


rule = is_slow
print("函数交给了 rule,此时还没有判断耗时。")
result = rule(1000)
print(f"调用 rule(1000) 得到:{result}")
# is_slow 是函数本身;is_slow(1000) 是调用后得到的结果。
运行 python 06_modules/function_name.py。rule = is_slow 让另一个名称指向同一个函数;rule(1000) 才会执行。这也是以后把函数交给其他工具使用的基础。
def is_valid(record):
    """判断这条日志是否符合本课的有效规则。
    输入:字段完整的日志字典。
    返回:True 或 False,不修改记录。"""
    valid_levels = ["INFO", "WARN", "ERROR"]
    return record["log_level"] in valid_levels and record["duration_ms"] >= 0
三引号中的文档字符串说明功能、输入与返回结果。本段用于阅读;下载文件中所有依赖函数已完整。
from log_tools import is_valid


help(is_valid)
运行 python 06_modules/read_help.py,先读函数名和参数,再读输入与返回说明。help 接收函数本身,不能写成 help(is_valid())。
from records import records
from log_tools import is_valid, is_slow, count_by_field


def main():
    valid_records = []
    invalid_count = 0
    for record in records:
        if is_valid(record):
            valid_records.append(record)
        else:
            invalid_count += 1

    level_counts = count_by_field(valid_records, "log_level")
    slow_count = 0
    for record in valid_records:
        if is_slow(record["duration_ms"]):
            slow_count += 1

    print(f"全部:{len(records)} 条;有效:{len(valid_records)} 条;无效:{invalid_count} 条")
    print(f"日志级别:{level_counts}")
    print(f"耗时达到 1000 毫秒:{slow_count} 条有效记录")


if __name__ == "__main__":
    main()
main() 是我们自己定义的组织函数。__name__ 是 Python 自动设置的名称;直接运行此文件时它等于 "__main__",最下方才会调用 main()。被导入时不执行这次入口调用。
运行与导入,分别观察
- 01
运行主程序
这样做在“演示”目录运行 python 06_modules/main.py。沿 main() 依次找到筛选、统计、判断和显示。
完成后应看到
全部 8 条、有效 6 条、无效 2 条;级别为 INFO 3、WARN 1、ERROR 2。
- 02
导入后再明确调用
这样做运行 python 06_modules/observe_import.py,打开代码,对照“导入已完成”和“现在调用 main.main()”两行。main.main() 中前一个 main 是模块,后一个 main 是其中的函数。
完成后应看到
导入时没有自动显示统计;明确调用后才出现统计结果。导入仍会执行模块顶层语句,并建立函数等名称。
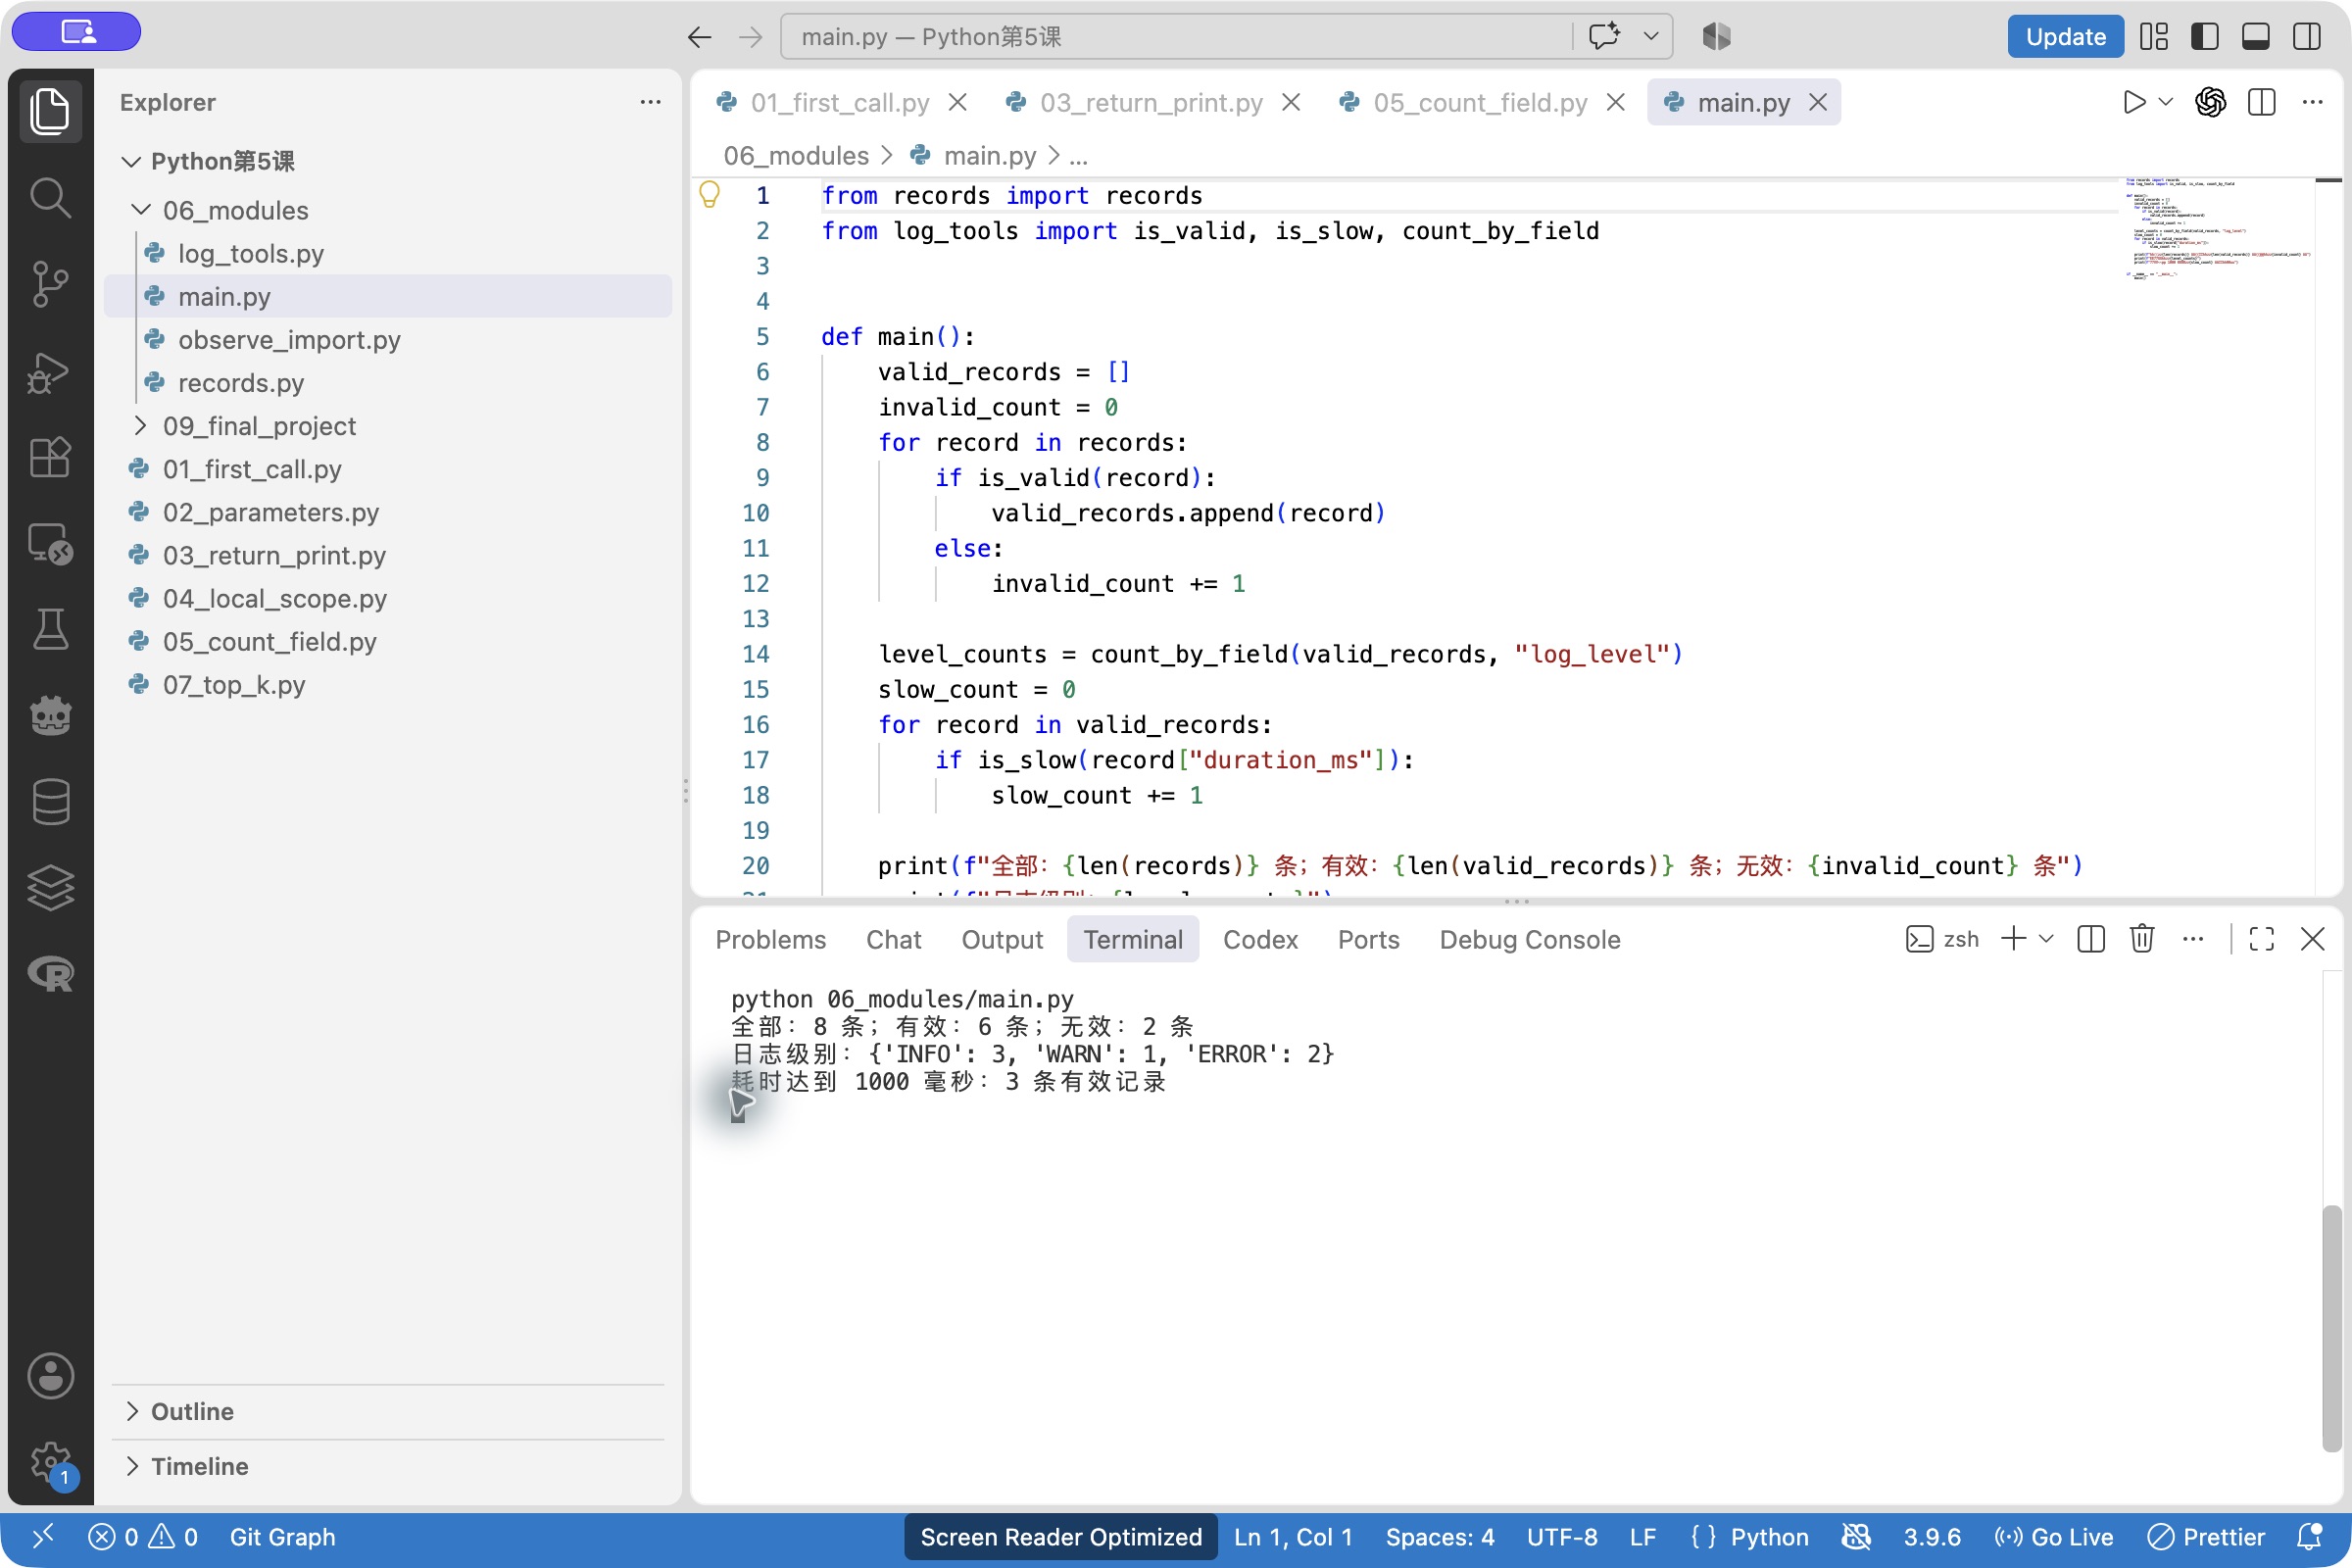
在左侧找三个文件,再在终端核对主程序返回的结果。
手机上可左右滑动;点击图片可以查看完整图看图理解,动手运行
用标准库取得前 K 项
已经得到次数,再按次数取出前 K 个项目,这就是 Top-K。
橙色框里的两项是 Top-2;这里取的是项目,不是原始日志的前两条。
手机上可左右滑动;点击图片可以查看完整图这些工具分别从哪里来
print、len 是内置功能,直接使用;collections 属于标准库,导入后使用;log_tools 是自己写的模块。以后使用的 NumPy、Pandas 是第三方包,安装与导入是两件事。
from collections import Counter


def top_k(counts, k=3):
    counter = Counter(counts)
    return counter.most_common(k)


counts = {"INFO": 3, "WARN": 1, "ERROR": 2}
print(f"出现最多的前两项:{top_k(counts, 2)}")
print(f"K 大于项目数:{top_k(counts, 10)}")
print(f"K 为 0:{top_k(counts, 0)}")

ties = {"LOGIN_FAILED": 2, "RESPONSE": 2, "LINK_UP": 1}
print(f"次数并列:{top_k(ties, 2)}")
Counter(counts) 接收计数字典,建立计数工具;方法就是这个工具可以执行的操作。most_common(k) 返回一个列表,每项是 (项目, 次数) 元组,之后用 item[0] 和 item[1] 分别取值。
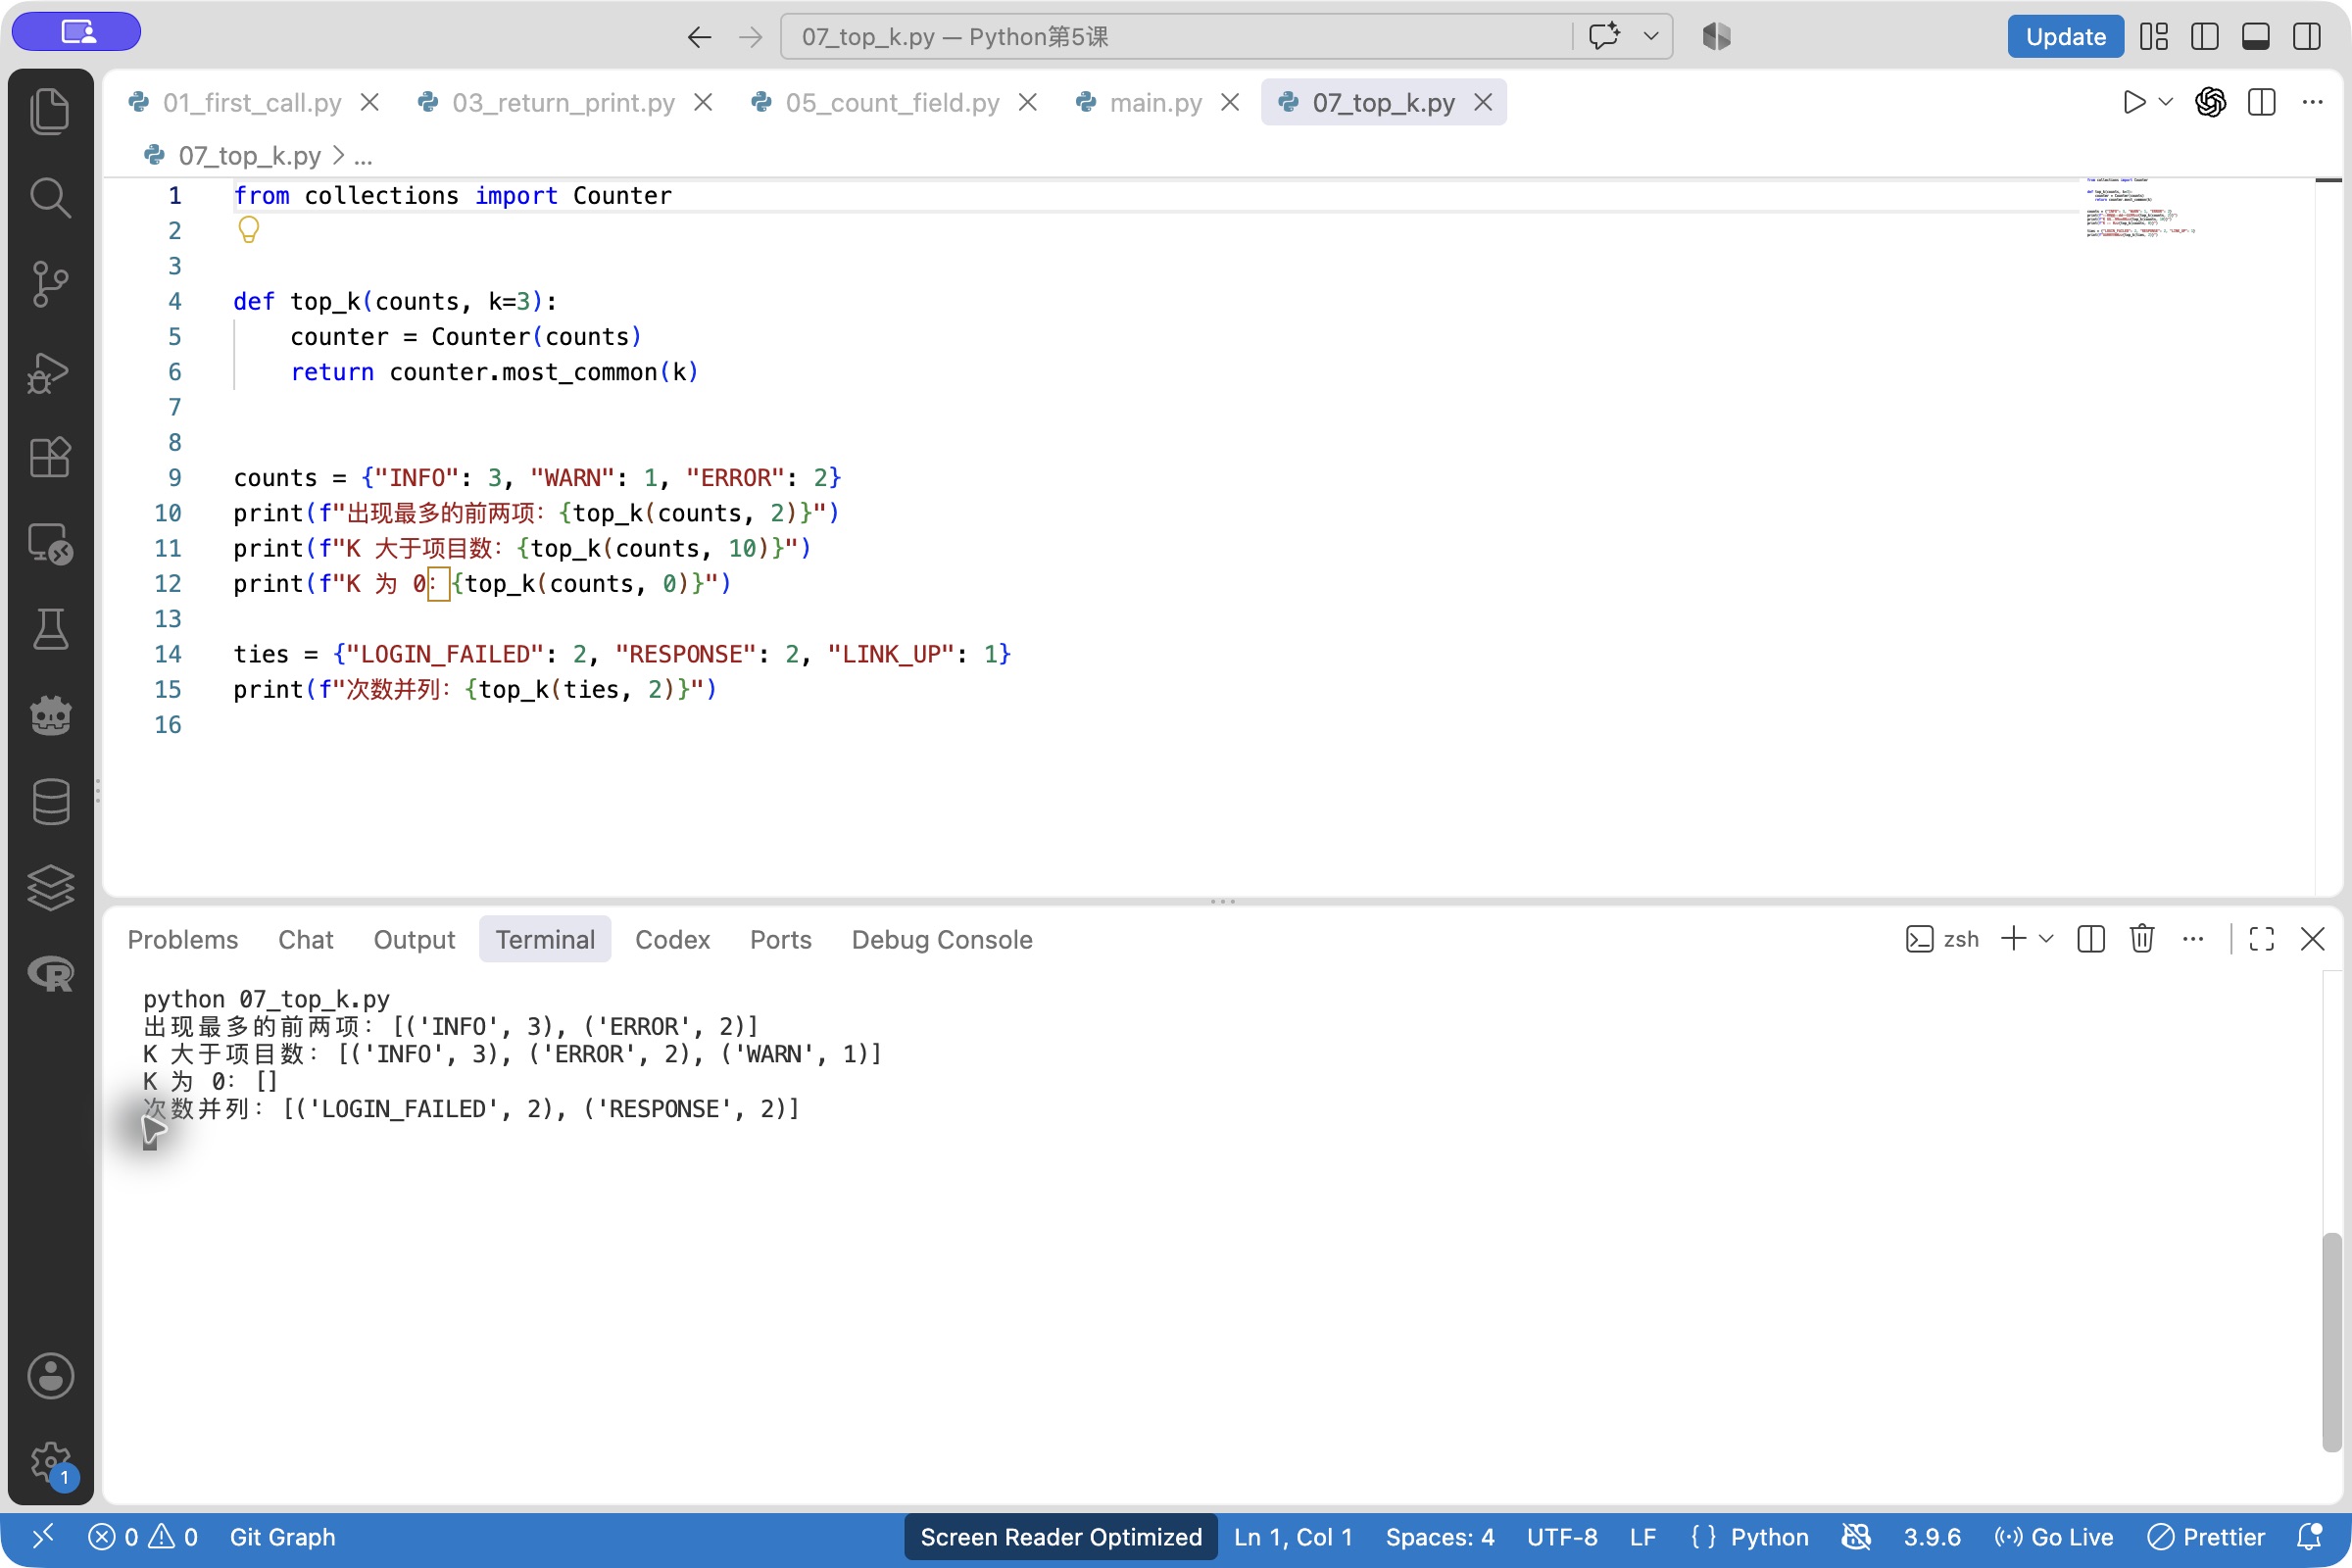
对照 K = 2、K = 10、K = 0;次数相同时,观察首次出现顺序。
手机上可左右滑动;点击图片可以查看完整图改变 K,解释结果
运行 07_top_k.py,把第一次调用的 2 改成 1 后重跑。
- 确认只得到 INFO 这一项,而不是一条原始日志。
- 说明项目不足 K 个时为什么只显示已有项目,K 为 0 时为什么没有项目。
看图理解,动手运行
组合成自己的日志工具
先看主程序如何组织数据,再在练习文件中完成同样的过程。
每条青色返回箭头都回到 main.py;一个函数返回后,主程序才决定下一步。
手机上可左右滑动;点击图片可以查看完整图先完整运行一次示范
- 01
对照图中的调用顺序
这样做在“演示”目录运行 python 09_final_project/main.py,再打开三个文件,找到每一项结果来自哪个函数。
完成后应看到
全部 8、有效 6、无效 2;INFO 3、WARN 1、ERROR 2;耗时达到 1000 毫秒共 3 条;IP 次数为 3、2、1。
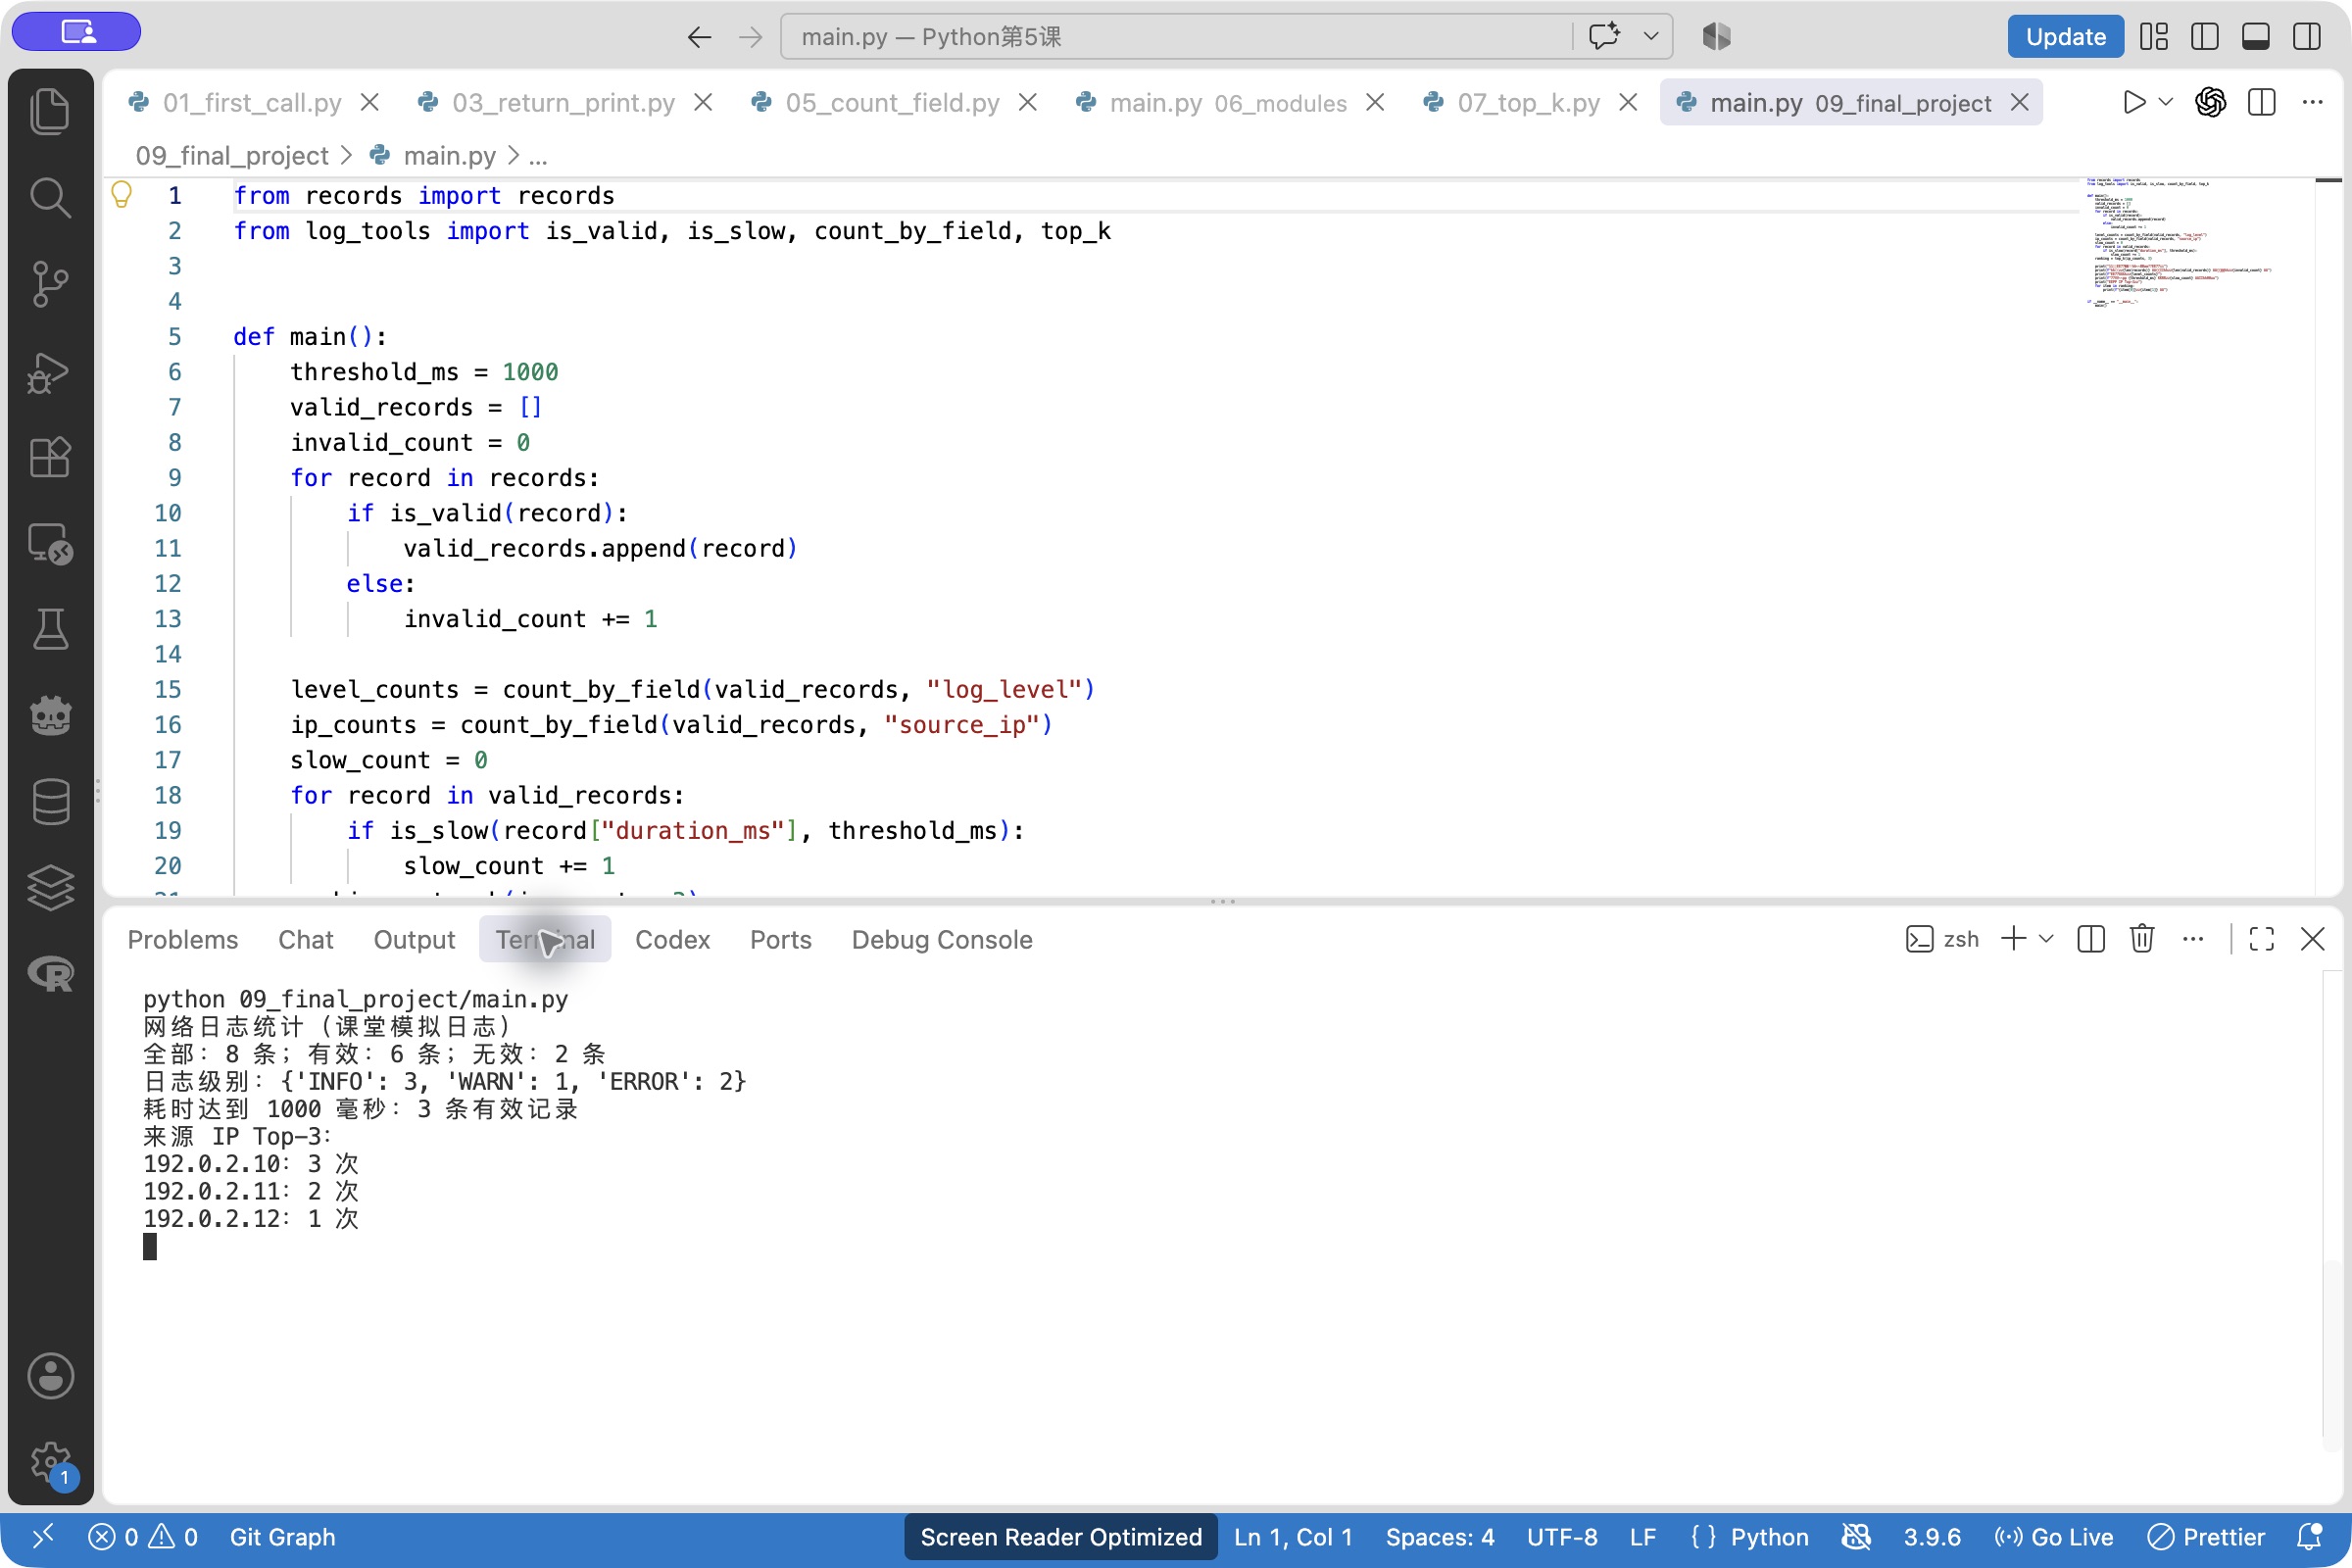
先看示范中的级别与 IP 结果;接下来保留这些函数,自己改为统计设备与事件。
手机上可左右滑动;点击图片可以查看完整图先决定每个函数负责什么
判断函数回答是否满足规则,筛选函数交回有效记录,计数函数交回次数,排名函数取得前几项。main 也是普通函数,由它安排调用并显示结果;函数通过参数与返回值合作。
给自己的函数写一张任务卡
这一次由你写出 select_valid,而不只是调用已经给出的函数。
左右滑动表格,可查看完整内容
| 问题 | 本次约定 |
|---|---|
| 完成什么 | 按原先顺序筛出有效日志 |
| 接收什么 | 字段完整的日志列表 records |
| 返回什么 | 一个新的有效记录列表 |
| 遇到空或全无效输入 | 返回空列表 |
| 是否修改原数据 | 不增删原列表,不改字典内容;结果里的字典仍与原记录共用 |
from records import records
from log_tools import is_valid


# 请在这里定义 select_valid(records)。
# 输入:字段完整的日志列表。
# 结果:只包含有效记录的新列表,保持原来的先后顺序。
# 要求:使用 is_valid 判断;不增删原列表,也不修改记录中的字段。
# 空列表与全无效输入都应返回空列表;重复调用不累计上次结果。
# 先用一句话说明函数职责,再写出参数、函数体和 return。


if __name__ == "__main__":
    print(f"课堂日志已准备好,共 {len(records)} 条。")
    print("请先写出 select_valid,再按下面的提示调用并观察结果。")
    # 完成函数后,在这里运行下面的调用并显示结果:
    # select_valid(records) 应得到六条有效记录。
    # select_valid([]) 应得到空列表。
    # select_valid([records[6], records[7]]) 应得到空列表。
    # 连续调用 select_valid(records) 两次,结果都应有六条记录。
    # 调用前后查看 records,八条原记录的内容应保持不变。
这里已有数据和判断函数,筛选函数由你设计并写出。先说明输入与结果,再写 def、循环、追加和 return,最后补上自己的调用。
先写函数,再接入主程序
- 01
完成自己的筛选函数
这样做在“学生练习”的 function_task.py 中写出 select_valid(records)。每次新建结果列表,用 is_valid 逐条判断,保留有效记录,循环后返回列表。
完成后应看到
函数使用传入参数,不依赖固定的外部 records;本次调用只负责筛选,不打印整份报告。
- 02
单独调用,说明边界
这样做在文件入口下按注释补充调用和输出。在左侧右击“学生练习”并在集成终端中打开,运行 python function_task.py;依次传入八条、空列表、全无效记录,再重复调用原数据。
完成后应看到
对应有效数量为 6、0、0;连续两次均为 6。原列表仍有八条记录,内容不变。
- 03
导入自己写的函数
这样做函数完成后,在 main.py 中加入 from function_task import select_valid,再用 valid_records = select_valid(records) 获取有效列表。
完成后应看到
调用发生在 main 中,筛选结果通过 return 回来;导入时不自动显示 function_task.py 的运行提示。
- 04
组合设备和事件统计
这样做用 count_by_field 统计 device 和 event,取前两个事件,再统计达到 1500 毫秒的数量。保存全部文件,在“学生练习”目录运行 python main.py。
完成后应看到
设备次数为 3、2、1;LOGIN_FAILED 与 RESPONSE 各 2 次;达到 1500 毫秒的有效记录有 2 条。
遇到这些现象,可以怎样改
用同一组输入重新运行,确认改动产生的结果。
左右滑动表格,可查看完整内容
| 看到什么 | 回到哪里 | 怎样处理 |
|---|---|---|
| 只定义函数,没有结果 | 调用处 | 加入函数名和括号,传入需要的数据 |
| 本应得到结果,却得到 None | 结果约定和实际走过的分支 | 先判断是否约定以 None 表示无效输入;若非约定,补上遗漏路径的 return |
| 只统计了第一条 | return 的缩进 | 把最终返回放到 for 结束之后 |
| 导入时找不到文件或函数 | 相关文件和导入语句 | 把依赖文件放在同一文件夹,核对名称并保存 |
| 传入参数数量不合适 | 函数定义与调用 | 按定义中的位置与默认值调整本次输入 |
展示你的结果与解释
展示自己写的 select_valid 和完整主程序。
- 先用一句话说明筛选函数的输入、返回和不修改原记录的约定,再展示边界结果。
- 沿 main → select_valid → is_valid 的调用说明:is_valid 返回给 select_valid,筛选完成后再返回 main。
- 把阈值从 1500 改成 1000,说明数量为何从 2 变成 3;用空数据后恢复原数据,结果不应累加。
把本课进度保存下来
登录后可以保存浏览内容、有效学习时间、完成状态和答题参与记录。